Что такое uptime и как его считают
Что такое uptime и зачем его измеряют
Uptime (аптайм, «время безотказной работы») — это доля времени, в течение которой сайт или сервис был доступен и корректно отвечал на запросы, от общего времени наблюдения за период. Проще говоря, это мера того, насколько часто ваш ресурс «лежит» по сравнению с тем, сколько он работает.
Показатель обычно выражают в процентах: 99.9%, 99.99% и так далее. Время недоступности, соответственно, называют downtime (даунтайм). Эти два понятия — две стороны одной медали: если uptime за месяц составил 99.9%, значит 0.1% месяца сайт был недоступен.
Зачем вообще следить за этим числом? Причин несколько, и они разного порядка:
- Для бизнеса. Каждая минута простоя — это несостоявшиеся продажи, заявки и регистрации. Зная реальный uptime, можно посчитать прямые потери и решить, сколько стоит вкладывать в надёжность.
- Для репутации. Пользователь, попавший на «сайт не отвечает», может больше не вернуться. Надёжность — часть доверия к бренду.
- Для SEO. Поисковые боты регулярно обходят сайт. Частые ошибки при обходе могут привести к снижению позиций и выпадению страниц из индекса.
- Для договорных отношений. Если вы работаете с хостингом или провайдером по SLA, фактический uptime — это аргумент в разговоре о компенсациях.
Важно понимать: uptime — это не статичная характеристика «хорошего» или «плохого» сервиса, а измеряемая величина, которую нужно считать по конкретной методике. Какой именно — зависит от того, как вы определяете «доступен».
Что считать «доступностью»: четыре разных взгляда
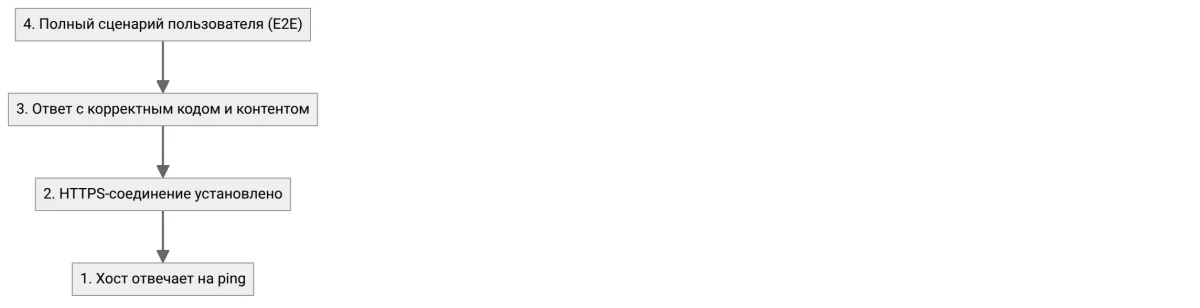
Прежде чем мерить uptime, нужно договориться, что вообще значит «сайт работает». Иначе два человека, говорящие про «99.9%», могут иметь в виду совершенно разные вещи. Вот четыре уровня, от грубого к строгому:
-
Хост отвечает (ping). Проверка, что сервер жив и отвечает на сетевом уровне. Самая слабая трактовка: сервер может пинговать, но при этом веб-приложение уже упало и отдаёт ошибку 500.
-
Сайт отдаёт ответ (HTTP-статус). Проверка, что веб-сервер возвращает код 200 (или другой ожидаемый). Уже ближе к правде, но код 200 может отдавать и страница-заглушка «ведутся работы».
-
Ответ корректный (контент). Проверка, что в ответе есть ожидаемый контент — определённое слово, элемент, признак работоспособности. Ловит случай, когда сайт «жив», но отдаёт пустую страницу или ошибку приложения, замаскированную под 200.
-
Работает вся цепочка (end-to-end). Проверка полного сценария пользователя: домен резолвится, SSL-сертификат валиден, страница грузится, ключевой запрос выполняется. Строжайшая трактовка, которая и отражает реальный пользовательский опыт.
| Уровень проверки | Что фиксируется | Что пропускает |
|---|---|---|
| Ping | Сервер в сети | Упавший веб-сервер, ошибку 500 |
| HTTP-статус | Код ответа сервера | Заглушку, ошибку приложения под кодом 200 |
| Контент | Наличие ожидаемых данных | Сбои в смежных сервисах, медленные ответы |
| End-to-end | Полный сценарий пользователя | Почти ничего, но сложнее в настройке |
Для мониторинга доступности сайта почти всегда выбирают уровень не ниже «HTTP-статус + контент»: именно так ловится большинство реальных сбоев. Проверить, что сайт отдаёт код 200 и отвечает сейчас, можно через проверку доступности UptimeChecker.
Как считают uptime: базовая формула
В основе любого расчёта лежит одно простое отношение: сколько времени сервис был доступен, делённое на общее время наблюдения.
uptime = (время доступности / общее время наблюдения) × 100%
Или, что эквивалентно, через время простоя:
uptime = (общее время − время простоя) / общее время × 100%
То же самое в терминах, которые чаще встречаются в статьях и документации:
uptime = (uptime / (uptime + downtime)) × 100%
Здесь uptime в правой части — это суммарное время доступности, downtime — суммарное время простоя, а их сумма даёт общий период наблюдения.
Разберём на простом примере. Допустим, за месяц (30 дней = 43 200 минут) сайт был недоступен в общей сложности 43 минуты. Тогда:
время доступности = 43 200 − 43 = 43 157 минут
uptime = 43 157 / 43 200 × 100% = 99.9%
Обратная ситуация: вы знаете, что провайдер обещает 99.99% за месяц, и хотите понять, сколько минут простоя это допускает:
время простоя = 43 200 × (1 − 0.9999) = 43 200 × 0.0001 = 4.32 минуты
Получается примерно 4 минуты 19 секунд на месяц. Детальный разбор этой формулы с несколькими примерами расчёта есть в отдельной статье про формулу доступности, а быстро перевести проценты в минуты и обратно можно через калькулятор доступности UptimeChecker.
Тонкости, из-за которых цифры «плавают»
Формула проста, но на практике одинаковые на первый взгляд сервисы показывают разный uptime. Причина — в деталях методики, которые редко проговаривают вслух.
Интервал проверки. Если мониторинг проверяет сайт раз в 5 минут, то сбой длительностью 1 минуту может вообще не попасть в журнал. Чем реже проверки, тем «оптимистичнее» картина: короткие сбои выпадают из статистики, и uptime завышается. Частые проверки, наоборот, ловят больше инцидентов.
Точки измерения. Сервис может быть доступен из Москвы, но недоступен из-за границы или у части провайдеров. Uptime, измеренный из одной точки, не отражает глобальную картину. Надёжные системы проверяют из нескольких географически распределённых локаций и считают доступность «по худшей» или по большинству.
Порог, после которого фиксируется сбой. Одна неудачная проверка ещё не значит, что сайт лёг: это может быть мимолётный сбой сети. Обычно инцидент фиксируют после двух-трёх подряд неудачных проверок. Меняя этот порог, можно влиять на итоговую цифру.
Плановые работы. Одни считают плановое обслуживание частью простоя, другие — исключают его из расчёта, поскольку оно «не считается» аварией. Это напрямую меняет итоговый процент: час деплоя раз в месяц — это уже заметная доля при уровне 99.99%.
Ошибки, которые «не видны». Если проверка смотрит только на HTTP-статус, то сайт, отдающий код 200 с пустой страницей, считается доступным. Реальный пользователь в этот момент видит сломанный ресурс — но статистика этого не заметит.
Вывод простой: прежде чем сравнивать чей-то uptime со своим, уточните методику. Цифра без описания того, как её измеряли, почти ничего не говорит.
Как uptime связан с SLA
На практике термины uptime и SLA постоянно соседствуют, и их полезно различать чётко. Это разные вещи с разным назначением.
- Uptime — это факт. Он показывает, как сервис реально работал за прошедший период. Его можно измерить и перепроверить.
- SLA — это обещание. Это целевое значение, которое провайдер обязуется обеспечить в будущем, плюс условия на случай, если не обеспечит.
Отсюда два практических следствия. Первое: SLA стоит проверять фактическим uptime. Обещать 99.9% просто, а вот удержать реальную доступность на этом уровне — уже инженерная задача. Второе: когда вы сравниваете сервисы, сравнивайте измеренные цифры, а не заявленные в договорах — они могут отличаться в разы.
Связь между ними удобно показать на числах. Обещание «99.9% в год» — это допущение не более 8 часов 45 минут простоя за год; «99.99%» — уже не более 52 минут. Детальный пересчёт процентов в минуты и обратно есть в статье про SLA 99.9% и реальное время простоя, а быстро посчитать свой случай можно в калькуляторе доступности.
Как измерить uptime своими руками
Базовую оценку можно получить без специальных сервисов — достаточно стандартных утилит командной строки. Это полезно и для разовой самопроверки, и для того, чтобы понять, как вообще устроен расчёт.
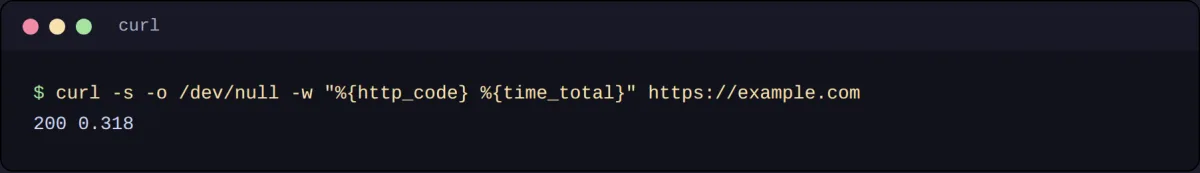
Самый простой способ — периодически запрашивать сайт через curl и записывать результат. Вот цикл, который раз в 30 секунд фиксирует HTTP-статус и время отклика:
while true; do
  result=$(curl -s -o /dev/null -w "%{http_code} %{time_total}" --max-time 10 https://example.com)
  echo "$(date '+%Y-%m-%d %H:%M:%S') $result" >> uptime.log
  sleep 30
done
Что здесь происходит:
curl -s -o /dev/null -w "%{http_code} %{time_total}"— запрашивает сайт, отбрасывает тело и печатает HTTP-код и общее время запроса в секундах.--max-time 10— ограничивает ожидание десятью секундами, чтобы зависший сервер не останавливал цикл.>> uptime.log— дописывает каждую строку в журнал, а не перезаписывает его.sleep 30— пауза между проверками.
После того как журнал накоплен за какое-то время (хотя бы сутки), посчитайте долю строк с кодом, отличным от 200. Например, из 2 880 проверок за сутки (раз в 30 секунд) 5 завершились ошибкой:
uptime = (2880 − 5) / 2880 × 100% = 99.83%
Полезно также проверить, что домен вообще резолвится и DNS-записи в порядке — сбой DNS выглядит для пользователя как полная недоступность:
dig example.com +short
Если команда вернула IP-адрес — домен резолвится. Если вывод пустой или содержит ошибку — проблема на уровне DNS, и сайт для части пользователей «лежит», даже если веб-сервер исправен. Разобрать все записи домена детально можно через проверку DNS-записей UptimeChecker.
Понятно, что ручной цикл — это скорее учебный инструмент, чем полноценный мониторинг: он не работает из нескольких точек, не умеет уведомлять и требует, чтобы машина всё это время была включена. Но он даёт главное — интуитивное понимание того, из чего складывается цифра uptime.
Где uptime используется на практике
Понимание uptime пригождается не только в отчётах. Вот несколько рабочих сценариев, где эта метрика реально влияет на решения.
-
Приёмка нового хостинга или провайдера. Перед миграцией разумно посмотреть фактическую доступность сервиса за прошлые месяцы, а не только обещания в SLA. Цифры из договора и реальность могут расходиться в разы.
-
Оценка ущерба от инцидента. После аварии, зная длительность простоя и среднюю выручку за час, можно посчитать прямые потери и обосновать вложения в надёжность.
-
Переговоры с клиентами. Если вы — агентство, ведущее сайты клиентов, фактический uptime — это наглядный аргумент качества вашей работы. Прозрачная отчётность по доступности повышает доверие сильнее, чем любые слова.
-
Настройка алертов. Зная типичный uptime и «нормальную» картину, вы быстрее заметите аномалию — например, что за неделю накопилось простоя больше, чем обычно за месяц.
-
Сравнение регионов и провайдеров. Если доступность заметно отличается между локациями, это сигнал о проблеме у конкретного провайдера или в конкретной географии.
Во всех этих сценариях работает одно правило: регулярные измерения ценнее разовых проверок. Один замер скажет, работает ли сайт прямо сейчас; серия замеров за месяц — даст uptime, на который можно опираться в решениях.
Чек-лист: как получить корректный uptime
Небольшой список того, что стоит держать в голове, чтобы цифра доступности была честной и сравнимой:
- Зафиксируйте период (день, месяц, год) и не меняйте его задним числом.
- Определите, что считаете доступностью: код 200, наличие контента или полный сценарий пользователя.
- Выберите интервал проверок — чем чаще, тем точнее картина и тем меньше «слепых зон».
- Проверяйте с нескольких точек, а не из одной локации.
- Договоритесь, входит ли плановое обслуживание в downtime.
- Сохраняйте журнал с метками времени, а не «прикидывайте» длительность сбоев по памяти.
Если все эти пункты закрыты, посчитанный uptime можно спокойно использовать в отчётах, переговорах и сравнениях — он будет означать то, что вы думаете.
UptimeChecker позволяет измерять доступность сайта и видеть её динамику, а не полагаться на разовые проверки. Если хотите понять, как считается доступность вашего ресурса прямо сейчас, начните с проверки доступности — а точную формулу и примеры расчёта разберём в статье «Формула доступности: как посчитать uptime».


