Формула доступности: как посчитать uptime
Зачем вообще считать доступность вручную
Формула uptime выглядит тривиально, но именно ручной расчёт даёт то, чего не даёт ни один готовый отчёт: понимание, из чего складывается цифра. Когда вы сами подставляете числа, становится видно, как интервал проверки, порог фиксации сбоя и длительность инцидента влияют на итоговый процент.
Есть как минимум три ситуации, где формула нужна по-настоящему:
-
Проверка обещаний провайдера. Хостинг заявляет 99.9%. Вы подняли свои журналы, посчитали фактическую доступность — и видите, сходится ли она с обещанием. Без расчёта это просто «вроде бы работало».
-
Переговоры о компенсациях. В SLA обычно прописаны штрафы или кредиты за превышение допустимого простоя. Чтобы требовать их, нужно уметь показать расчёт, а не просто «сайт лежал».
-
Планирование надёжности. Зная, сколько минут простоя вы можете себе позволить при целевом уровне, вы понимаете, сколько стоит резервирование и какие меры оправданы.
Всё это сводится к одной формуле, которую мы сейчас разберём по частям и подкрепим примерами с конкретными числами.
Сама формула и её составляющие
Базовая формула доступности — это отношение времени, когда сервис был доступен, к общему времени наблюдения:
uptime = (uptime / (uptime + downtime)) × 100%
Здесь важно не запутаться в обозначениях: в правой части uptime и downtime — это не проценты, а суммарные длительности за период.
uptime— суммарное время, в течение которого сервис был доступен (отвечал корректно).downtime— суммарное время, когда сервис был недоступен.uptime + downtime— общий период наблюдения (знаменатель).
То есть формула в более явном виде читается так:
uptime % = (суммарное время доступности / общий период наблюдения) × 100%
Эквивалентная запись через время простоя, которая часто удобнее, когда проще посчитать именно простои:
uptime % = (общий период − суммарное время простоя) / общий период × 100%
Обе записи дают один и тот же результат. Какую использовать — вопрос того, что у вас уже есть: журнал доступности или список инцидентов с их длительностями.
Пример 1: считаем uptime по известному простою
Самый частый случай: вы знаете, что за месяц сайт падал трижды, и помните длительность каждого сбоя. Нужно перевести это в процент доступности.
Исходные данные за месяц (30 дней = 43 200 минут):
- сбой 1 — 25 минут (плановый деплой пошёл не так);
- сбой 2 — 12 минут (исчерпание ресурсов при всплеске трафика);
- сбой 3 — 6 минут (кратковременная сетевая авария).
Суммарный простой:
downtime = 25 + 12 + 6 = 43 минуты
Время доступности:
uptime = 43 200 − 43 = 43 157 минут
Подставляем в формулу:
uptime % = (43 157 / (43 157 + 43)) × 100% = (43 157 / 43 200) × 100% = 99.9004%
Округляя до одного знака после запятой, получаем 99.9%. Обратите внимание на важный нюанс: 43 минуты простоя за месяц — это ровно тот лимит, который «стоит» уровень 99.9%. Один лишний сбой на пару минут — и вы уже ниже этого порога.
Пример 2: считаем допустимый простой по целевому уровню
Обратная задача, которая возникает при выборе тарифа или написании SLA: у вас есть целевой процент, и нужно понять, сколько минут простоя он допускает.
Допустим, вы хотите держать уровень 99.99% за год (365 дней = 525 600 минут). Из формулы выражаем допустимый простой:
допустимый простой = общий период × (1 − уровень доступности)
допустимый простой = 525 600 × (1 − 0.9999)
допустимый простой = 525 600 × 0.0001 = 52.56 минуты
Итого — 52 минуты 34 секунды на весь год. Это сразу расставляет приоритеты: при таком бюджете даже одна плановая остановка сервера на час означает, что уровень 99.99% за год уже не выполнить. Отсюда и вытекают архитектурные требования — деплои без остановки, резервирование, автоматическое переключение.
Проверим себя обратным расчётом. Если за год фактический простой составил 60 минут, то:
uptime % = (525 600 − 60) / 525 600 × 100% = 99.9886%
Получилось 99.9886% — формально чуть ниже обещанных 99.99%. Вот так «мелочь» в 8 минут сверх бюджета формально нарушает уровень «четырёх девяток».
Пример 3: считаем по журналу проверок (с проверками из командной строки)
На практике у вас чаще нет готового списка длительностей сбоев, зато есть журнал периодических проверок. Тогда uptime считают как долю успешных проверок среди всех.
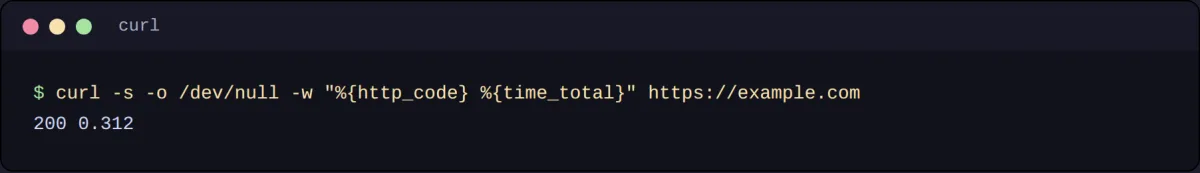
Соберём журнал с помощью curl, который раз в 60 секунд записывает HTTP-код:
for i in $(seq 1 1440); do
  code=$(curl -s -o /dev/null -w "%{http_code}" --max-time 5 https://example.com)
  echo "$(date '+%H:%M:%S') $code" >> uptime.log
  sleep 60
done
Пояснения по строкам:
seq 1 1440— 1 440 итераций, то есть ровно сутки при паузе в минуту.curl -s -o /dev/null -w "%{http_code}"— делает запрос и печатает только код ответа, без тела.--max-time 5— обрывает запрос через 5 секунд, если сервер завис (такой запрос запишется пустым кодом и считается сбоем).>> uptime.log— дописывает результат в журнал, а не перезаписывает файл.
После того как журнал собран, считаем долю успешных проверок. Допустим, из 1 440 строк у 1 437 код 200, а в трёх строках либо пусто, либо код 500. Тогда:
uptime % = (количество успешных проверок / общее число проверок) × 100%
uptime % = (1 437 / 1 440) × 100% = 99.79%
Этот способ удобен тем, что не требует знать точную длительность каждого сбоя — достаточно доли успешных замеров. Но у него есть своя погрешность: сбои, которые происходили между проверками и закончились до следующей, остаются незамеченными. Поэтому результат по журналу проверок всегда чуть «оптимистичнее», чем реальная доступность, — и тем точнее, чем чаще проверки.
Типичные ошибки при расчёте
Формула простая, но именно на ней спотыкаются чаще всего. Вот ошибки, которые регулярно всплывают в отчётах.
| Ошибка | В чём суть | Как правильно |
|---|---|---|
| Сложение процентов | «99.9% + 99.9% = 199.8%» | Проценты доступности не складываются; складываются только длительности |
| Неверный период | Считать год как 360 дней или «прикидывать» месяцы | Фиксировать период точно: год = 365 дней, месяц = число дней в календаре |
| Путаница с нулями | 0.1% = 0.01, а не 0.001 | Помнить: 1% = 0.01, 0.1% = 0.001, 0.01% = 0.0001 |
| Игнорирование плановых работ | Не считать деплой простоем «потому что плановый» | Договориться явно: входит плановое обслуживание в downtime или нет |
| Среднее вместо суммы | Брать «средний простой за сбой» и умножать на число сбоев | Суммировать фактические длительности всех инцидентов |
Самая коварная — путаница с нулями. Ошибка на один порядок превращает 99.99% в 99.9% или наоборот, а это разница в десять раз по времени простоя. Если вы сомневаетесь в своих вычислениях, проще перепроверить через калькулятор доступности UptimeChecker: он переводит проценты в минуты и обратно, исключая арифметические ошибки.
Перевод между процентами и минутами: опорная таблица
Формула одна, но в разных разговорах одни и те же величины выражают то в процентах, то в минутах, то в часах. Чтобы не пересчитывать каждый раз, полезно держать в голове опорные значения для самых ходовых уровней.
Напомним базу: год = 365 дней = 525 600 минут, месяц в расчётах обычно берут как 30 дней = 43 200 минут. Допустимый простой считается по той же формуле, что мы вывели выше:
допустимый простой = длительность периода × (1 − уровень доступности)
| Уровень доступности | Простой в год | Простой в месяц (30 дней) | Простой в день |
|---|---|---|---|
| 99% | 3 дня 15 ч 36 мин | 7 ч 12 мин | 14 мин 24 с |
| 99.9% | 8 ч 45 мин 36 с | 43 мин 12 с | 1 мин 26 с |
| 99.95% | 4 ч 22 мин 48 с | 21 мин 36 с | 43 с |
| 99.99% | 52 мин 34 с | 4 мин 19 с | 8.6 с |
| 99.999% | 5 мин 15 с | 26 с | 0.9 с |
Строка с 99% добавлена не случайно: она хорошо показывает масштаб. Разница между «одной девяткой» (99%) и «тремя» (99.9%) — это не 0.9%, а переход от трёх с половиной суток простоя в год к восьми часам. Каждый добавленный знак после запятой делит допустимый простой на десять.
Если вы считаете для нестандартного периода — квартала, недели, суток — подставляйте его длительность в формулу, а не интерполируйте «на глаз». Ошибка в выборе периода — одна из самых частых причин неверных цифр в отчётах.
Погрешность: что остаётся «за скобками» формулы
Формула точна арифметически, но на вход ей подают данные, которые сами по себе содержат погрешность. Понимание этих погрешностей важно, чтобы не выдать желаемое за действительное.
Гранулярность измерений. Если проверки идут раз в 5 минут, то любой сбой короче 5 минут может либо попасть в замер, либо нет — в зависимости от того, совпал ли момент проверки с моментом сбоя. Итоговый uptime, посчитанный по таким данным, содержит систематическую ошибку в сторону завышения: короткие сбои пропадают.
Погрешность по границам инцидента. Когда вы знаете только «сайт лежал примерно с 15:00 до 15:40», реальная длительность может отличаться на несколько минут. При уровне 99.99%, где весь месячный бюджет — 4 минуты, такая неопределённость способна полностью изменить вывод.
Несколько точек наблюдения. Доступность из одной локации — это одна цифра, из десяти — уже диапазон значений. Какую из них считать «истинной»? Обычно берут либо худшую, либо медиану, но методику нужно зафиксировать заранее, иначе расчёт не воспроизводим.
Из этого следует практический совет: фиксируйте методику вместе с результатом. Записывайте не только «uptime 99.94%», но и период, интервал проверок, точки измерения и порог, после которого фиксируется сбой. Только так цифру можно сравнивать с прошлыми периодами и с чужими отчётами.
От расчёта к регулярному мониторингу
Ручной расчёт даёт точку опоры, но у него есть фундаментальное ограничение: он смотрит в прошлое. Вы узнаёте, сколько сайт лежал, уже после того, как это случилось. Для реальной работы этого мало — нужны регулярные измерения, которые фиксируют доступность непрерывно и позволяют увидеть сбой в момент его возникновения.
Схематически разница такая:
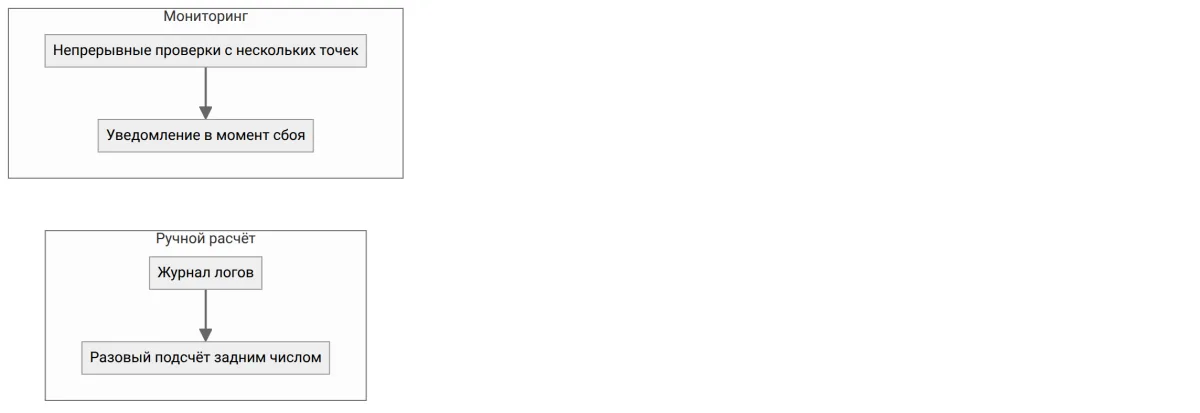
Что даёт регулярный мониторинг по сравнению с разовым расчётом:
- Актуальность. Вы видите доступность сейчас, а не итог за прошлый месяц.
- Частота проверок. Чем чаще замеры, тем точнее картина и тем меньше «слепых зон» между проверками.
- Несколько точек. Доступность, измеренная из одной локации, не отражает глобальную картину; проверки из разных регионов честнее.
- Автоматический журнал. Инциденты фиксируются с точными метками времени, и итоговый uptime считается сам, без ручной возни с лог-файлами.
То есть формула остаётся той же самой — меняется только то, кто и как собирает для неё данные. Ручной расчёт хорош для разовой проверки и понимания методики; для непрерывного контроля нужен инструмент, который измеряет доступность сам.
Коротко: формула и три опорных вывода
Соберём главное, чтобы формула закрепилась как рабочий инструмент, а не как строчка в статье.
uptime % = (время доступности / общий период наблюдения) × 100%
допустимый простой = общий период × (1 − уровень доступности)
Три вывода, которые стоит вынести из всего расчёта:
- Складывать нужно длительности, а не проценты. Суммируйте минуты всех сбоев, а потом делите на период — только так формула даёт корректный результат.
- Каждый «девятый» знак — это порядок. 99.9% допускает в десять раз больше простоя, чем 99.99%, и в сто раз больше, чем 99.999%. Не путайте их при выборе целевого уровня.
- Результат зависит от методики так же, как от самой формулы. Период, интервал проверок и определение доступности влияют на итоговую цифру не меньше, чем арифметика.
Подробнее о том, что вообще такое доступность и как её определяют, читайте в статье «Что такое uptime и как его считают». А чтобы не считать вручную и сразу видеть фактическую доступность вашего ресурса, проверьте его через UptimeChecker — сервис покажет, отвечает ли сайт сейчас и соответствует ли его доступность заявленному уровню.


