Журнал инцидентов: зачем он нужен и как вести его без усилий
Запись об инциденте — это не отчёт для руководства и не бюрократическая формальность. Это рабочий инструмент, который отвечает на три вопроса: что именно сломалось, как долго это длилось и почему повторилось. Если ответы приходится восстанавливать по переписке в мессенджере, значит журнала у вас нет — есть память отдельных людей, и она заканчивается вместе с их отпуском.
Журнал инцидентов в кабинете UptimeChecker — отдельный инструмент. Он работает независимо от статус-страницы: можно вести записи только для внутреннего использования, а можно показывать часть из них клиентам. Ниже — как он устроен, что в него писать, чем он отличается от статус-страницы и как сделать так, чтобы ведение журнала не превратилось в ещё одну задачу, которую все откладывают.
Журнал инцидентов: что это и чем он не является
Журнал — это упорядоченный список записей о сбоях и работах, где у каждой записи есть начало, конец, оценка влияния, статус разбора, причина и хроника короткими сообщениями. Ключевое слово здесь — «упорядоченный». Не «подробный», не «красивый», а именно предсказуемый по структуре: одна запись всегда содержит один и тот же набор полей, поэтому по журналу можно считать статистику, а не читать его как роман.
Чем журнал не является:
- Не заменой мониторинга. Проверки говорят, что сайт сейчас недоступен. Журнал говорит, что с этим делали и почему это случилось. Одно без другого неполно.
- Не заменой статус-страницы. Это разные инструменты с разной аудиторией, о разнице — отдельный раздел ниже.
- Не логом сервера. Логи пишут машины для машин, журнал пишут люди для людей. Попытка залить в журнал сырые логи превращает его в свалку, по которой ничего не считается.
- Не местом для поиска виноватых. Как только журнал начинают использовать как «доску позора», люди начинают писать в него осторожные формулировки вместо правды, и данные теряют ценность.
Зачем журнал нужен: пять задач, которые он закрывает
- Считать простой честно. Не «кажется, часов пять за месяц», а конкретное число: суммарный простой и средняя длительность инцидента за период. Это цифра, которую можно показать клиенту или положить в отчёт.
- Видеть повторяющиеся причины. Один и тот же сбой, случающийся раз в две недели, — это не «иногда падает», а конкретная проблема с конкретным приоритетом. Журнал с заполненной причиной показывает такие повторы сразу.
- Отвечать клиенту без переписки. Когда клиент спрашивает «а что вчера было», вы открываете запись и пересказываете хронику, а не вспоминаете.
- Обосновывать работы. Запись «переехали на новый сервер, потому что за квартал было четыре инцидента по исчерпанию памяти» убеждает заказчика лучше, чем «так надёжнее».
- Не терять контекст между людьми. Инцидент в пятницу вечером и разбор в понедельник утром часто делают разные люди. Журнал — то место, где контекст переживает выходные и смену дежурного.
Журнал инцидентов и статус-страница: в чём разница
Это самое частое смешение, поэтому разберём подробно. Подробный разбор статус-страниц — в статье «Статус-страница: что это, кому нужна и какую проблему решает», здесь важна граница.
| Журнал инцидентов | Статус-страница | |
|---|---|---|
| Для кого | Команда: разработчики, поддержка, аккаунт-менеджер | Внешние люди: клиенты, пользователи |
| Что показывает | Все записи, включая внутренние | Только то, что вы осознанно опубликовали |
| Кто видит | Никто снаружи, пока вы не решите иначе | Все, у кого есть ссылка |
| Обязательные поля | Влияние, статус разбора, причина при закрытии | Обычно достаточно заголовка и статуса |
| Роль | Память и аналитика | Коммуникация |
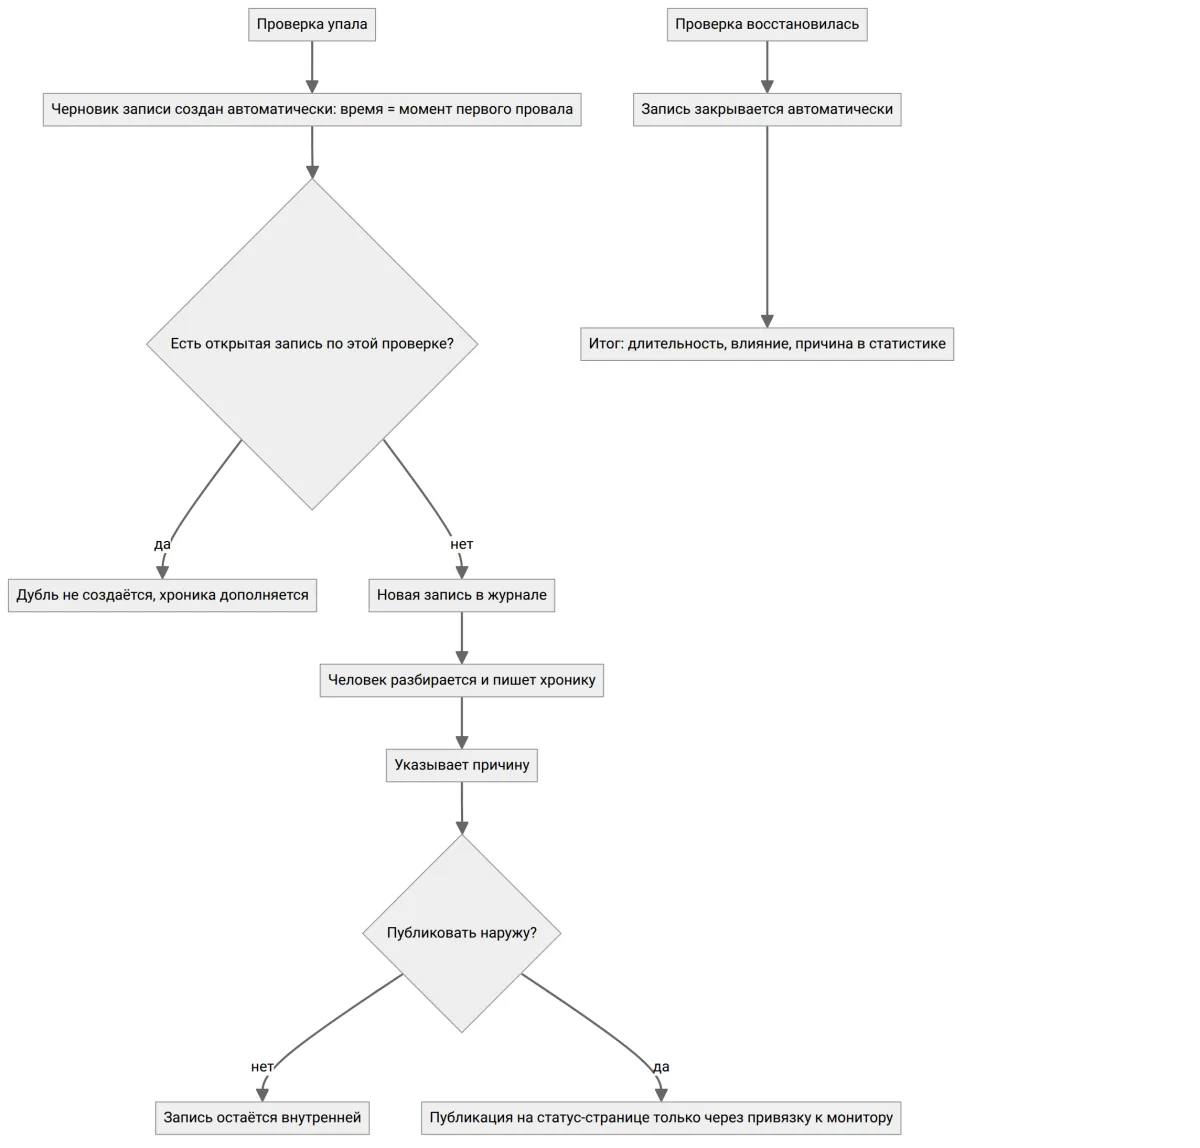
Журнал — это внутренняя память. Статус-страница — это внешнее сообщение. Запись можно опубликовать на статус-странице или оставить внутренней: публикация не копирует запись куда-то, а делает видимой тот же объект.
Здесь действует жёсткое правило: запись без привязки к проверке наружу не выходит никогда, даже если у неё стоит отметка «опубликовано». Связь со страницей идёт только через монитор, и на странице видны инциденты лишь тех проверок, которые на неё добавлены. Это защита от случайной публикации: пока запись не связана с проверкой, добавленной на страницу, снаружи её не будет.
Что фиксировать в записи об инциденте
У записи об инциденте есть фиксированный набор полей: начало, конец, влияние (нет / незначительное / существенное / критичное), статус разбора (разбираемся → причина найдена → следим → устранено), причина (заполняется при закрытии) и хроника короткими записями. Каждое поле существует не просто так.
| Что фиксировать | Зачем это нужно |
|---|---|
| Начало инцидента | Без него нельзя посчитать длительность и суммарный простой за период |
| Конец инцидента | Отделяет «ещё чиним» от «уже закончилось», закрывает запись для статистики |
| Влияние (нет / незначительное / существенное / критичное) | Позволяет отделить «упало всё» от «отвалился один лендинг», расставляет приоритеты разбора |
| Статус разбора (разбираемся → причина найдена → следим → устранено) | Видно, сколько инцидентов висит незакрытыми и на какой стадии они застряли |
| Причина (при закрытии) | Единственный источник статистики причин: без неё топ причин и выводы невозможны |
| Хроника короткими записями | Восстанавливает ход событий по минутам без чтения логов и переписки |
| Видимость (внутренняя / опубликована) | Разделяет внутреннюю память и внешнюю коммуникацию |

Влияние: почему четыре градации, а не «упало / не упало»
Градация нужна, чтобы не путать разные по значимости события в одной статистике. «Нет влияния» — событие, которое заметили только вы: плановая перезагрузка сервиса, короткий рестарт без ошибок. «Незначительное» — часть пользователей увидела ошибку, но всё быстро вернулось. «Существенное» — сайт или ключевая функция недоступны, есть поток жалоб. «Критичное» — недоступен весь сервис или потеряны данные.
Без градации суммарный простой получается либо драматично завышенным, либо наоборот незаметным: три секунды рестарта и три часа полной недоступности весят одинаково, если у события нет оценки влияния.
Статус разбора: где именно застревают инциденты
Переходы «разбираемся → причина найдена → следим → устранено» — это не формальный маршрут, а диагностика процесса. Если половина записей за месяц застряла на «разбираемся», проблема не в журнале, а в том, что у разбора нет владельца. Если записи подолгу стоят на «следим», это сигнал, что фикс отложили и надеются, что «само пройдёт».
Причина обязательна при закрытии
Причина при закрытии — обязательное поле, и это не придирка. Без неё статистика причин бессмысленна: вы получаете список инцидентов без объяснения, почему они происходят, а значит не можете ни приоритизировать работы, ни доказать, что принятая мера помогла.
Практическое правило: причина формулируется не как «упал сервер», а как «исчерпание пула соединений в приложении из-за медленного запроса в БД». Формулировка уровня «что именно было корнем» позволяет через месяц увидеть, что три из пяти инцидентов — про одно и то же.
Как вести журнал без усилий
Главная причина, по которой журналы не ведут, — кажется, что на это уходит время. Усилия убираются двумя способами: часть записей создаётся автоматически, а часть ведётся прямо в момент работы.
Что создаётся автоматически
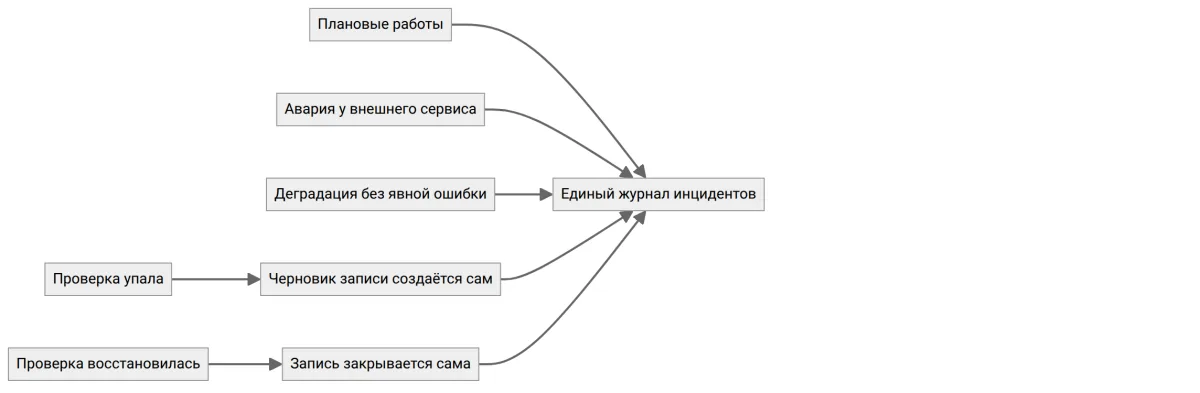
- При падении проверки запись создаётся сама. Время начала — реальное время первого провала, а не момент, когда вы открыли кабинет. Разница заметна на коротких сбоях: пока вы узнали, инцидент уже мог закончиться, и без журнала он бы просто исчез из вашей картины мира.
- При восстановлении запись закрывается сама. Конец инцидента фиксируется по факту восстановления проверки, а не по тому, когда вы вспомнили нажать кнопку.
- Дубль не создаётся. Если открытая запись по этой проверке уже есть, новая не появляется — вместо этого продолжает жить существующая. Это спасает от «мигающих» сбоев, когда сайт падает и поднимается каждые несколько минут.
- Что не автоматизируется: такая запись остаётся черновиком. Причину пишет и публикует человек. Автоматика знает факт сбоя, но не знает, почему он случился.
Что придётся завести руками
Не всё видно снаружи проверкой, поэтому некоторые записи создаются вручную:
- плановые работы — обновление, миграция, переезд;
- авария на стороне внешнего сервиса, из-за которой ваша функция не работает;
- деградация, которую проверка не ловит: например, медленно для части пользователей или некорректный результат вместо ошибки.
Такие записи ведутся в том же журнале, что и автоматические, — иначе статистика становится лоскутной.
Хроника: три-четыре строки вместо отчёта
Хроника — это короткие записи по ходу разбора, а не итоговый документ. Рабочий формат такой:
09:41— заметили рост 502 на проверке главной;09:48— перезапустили пул приложений, ошибки снизились;10:12— стабильно, наблюдаем;12:30— закрыли. Причина: исчерпание пула соединений.
Каждая строка пишется в момент события и занимает секунды. Итог: у вас есть восстановленная картина дня, которую не нужно собирать заново. Если вести хронику только «в конце», половина деталей потеряется, а вместе с ними — и причина.
Типичные ошибки ведения журнала
| Ошибка | К чему приводит | Как правильно |
|---|---|---|
| Закрывать записи без причины | Статистика причин пустая, повторяющиеся сбои не видны, работы не приоритизируются | Причина — обязательный шаг закрытия; правило простое: нет причины, нет закрытия |
| Писать в журнал сырые логи и трейсы | Записи становятся нечитаемыми, их перестают открывать | В журнал — только хроника человеческим языком; логи живут отдельно |
| Фиксировать время «когда заметили» | Длительность сбоя занижается, статистика простоя теряет смысл | Использовать реальное время первого провала и восстановления |
| Публиковать всё подряд на статус-страницу | Клиенты видят внутренние технические детали и лишний шум | Публиковать только то, что имеет смысл снаружи: влияние, статус, короткая хроника |
| Помечать плановые работы постфактум как «плановые» | Простой исчезает из статистики, uptime выглядит лучше, чем был | Плановые работы помечать заранее; задним числом это статистику не улучшает |
| Заводить журнал в отдельной таблице вне мониторинга | Записи расходятся с реальными данными проверок, часть инцидентов теряется | Держать журнал там, где живут проверки — тогда факты берутся автоматически |
| Разбирать инцидент через неделю | Контекст потерян, причина формулируется наугад | Хронику писать по ходу, причину — в день разбора |
Разбор аварии: минимум данных, который стоит собрать
Хроника в журнале — это текст. Но чтобы написать в причину что-то осмысленное, нужны факты с места. Ниже — минимальный набор команд, которые стоит прогнать при разборе недоступности. Они быстро отделяют проблемы DNS от проблем TLS, а проблемы TLS — от проблем приложения.
# 1. Доступность и код ответа, с таймингами (DNS, connect, TLS, TTFB)
curl -sS -o /dev/null -D - -w '\ncode=%{http_code} dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total}\n' \
  https://example.com/

# 2. Полный стек редиректов: где именно теряется запрос
curl -sS -o /dev/null -L -w '%{http_code} %{url_effective}\n' https://example.com/

# 3. Резолвинг: адрес и время ответа DNS
dig +short example.com A
dig example.com A | grep -E 'Query time|ANSWER:'

# 4. Консистентность DNS на разных резолверах (рассинхрон после переезда)
dig +short @1.1.1.1 example.com
dig +short @8.8.8.8 example.com

# 5. TLS: срок сертификата, цепочка, имя
openssl s_client -connect example.com:443 -servername example.com </dev/null 2>/dev/null \
  | openssl x509 -noout -subject -issuer -dates

# 6. Что происходит на уровне HTTP, если curl молчит
curl -sSv -o /dev/null https://example.com/ 2>&1 | head -n 40
Что делать с выводом команд
curlотдаёт код, но TTFB большой — сервер жив, проблема в приложении или БД, а не в сети. Ищите медленный запрос. Полезно сверить с материалом про медленный TTFB.curlне соединяется вообще — держите под рукой порядок проверок из статьи «Сайт упал: чек-лист диагностики»: сначала резолвинг, потом порт, потом TLS, потом приложение.digдаёт разные ответы с разных резолверов — вероятна проблема с DNS или с пропагацией, а не с сервером.opensslпоказывает близкую датуnotAfter— просроченный сертификат выглядит как недоступность для всех пользователей, хотя сервер отвечает.- Сбой повторяется рывками — это уже не разовый инцидент, а класс проблем; как его ловить, разобрано в материале про периодически падающий сайт.
Главное — результат этих команд не остаётся в терминале. Короткая сводка уходит в хронику записи, а вывод в причину. Так следующий человек, открывший инцидент, не начинает разбор с нуля.
Плановые работы и честный uptime
Плановые работы помечаются отдельно и на расчёт uptime не влияют. Это важно понимать правильно: простой считается по результатам проверок, и никакая пометка не может задним числом улучшить статистику. Если сайт лежал три часа, а потом вы пометили окно как плановые работы после факта, цифра uptime не изменится.
Отсюда практика: планируете окно обслуживания — заведите запись заранее, с началом и концом, и пометьте как плановую работу. Тогда в журнале останется след, объясняющий провал проверок, а в статистике не будет искусственных «улучшений». Для агентств это ещё и способ показать клиенту прозрачность: работа была заявлена, а не «мы что-то там чинили ночью».
Что показывает дашборд
На дашборде кабинета журнал собирается в пять цифр и разбивок, которые дают картину за 30 дней:
- число инцидентов за 30 дней — общая «температура» инфраструктуры;
- суммарный простой — сколько всего времени сервисы были недоступны;
- средняя длительность инцидента — показывает не количество сбоев, а скорость реакции;
- топ причин — какие проблемы повторяются чаще всего; прямое указание, что чинить первым;
- разбивка по проверкам — какой конкретно сайт или сервис даёт больше всего проблем.
Смотреть на эти цифры стоит не раз в год перед отчётом, а в конце каждой недели: недельный обзор занимает пару минут, зато повторяющуюся причину видно сразу, а не через квартал. Смежная тема — как такие цифры превращаются в договорённости по срокам реакции: см. шаблон SLA для агентства.
Мини-процесс: как вести журнал без усилий
- Настройте проверки на то, что важно клиенту. Журнал наполняется по фактам проверок, поэтому качество журнала начинается с набора проверок.
- Дайте автоматике создавать черновики. Не отключайте автосоздание: именно оно избавляет от ручного «ой, надо записать».
- Заведите привычку писать хронику на ходу. Одно-два сообщения во время разбора, не отчёт после.
- Не закрывайте запись без причины. Даже если причина неприятная («мы забыли про лимит соединений»), она ценнее, чем пустое поле.
- Раз в неделю смотрите топ причин. Если одна причина повторяется третий раз — это не инцидент, это задача в бэклог.
- Публикуйте наружу осознанно. Внутренние детали — в журнале, понятное клиенту — на статус-странице и только через привязку к монитору.
Итого
Журнал инцидентов ценен не сам по себе, а тем, что превращает разрозненные аварии в управляемую статистику. Автоматические черновики снимают с команды рутину, обязательная причина не даёт статистике выродиться в список дат, а разделение «внутреннее / опубликованное» позволяет говорить с клиентами честно и не показывать лишнего.
Попробуйте на бесплатном тарифе
Журнал инцидентов доступен на обоих тарифах и не ограничен лимитом страниц — начать можно без оплаты. На бесплатном тарифе доступно 3 сайта, 9 проверок и 1 статус-страница. Этого достаточно, чтобы завести проверки, получить первые автоматические черновики и посмотреть через пару недель на реальный топ причин вместо догадок. Если понадобится больше проверок и страниц — на тарифе Pro за 299 ₽/мес доступно 45 проверок и 10 статус-страниц, а обязательный копирайт можно отключить.
Зарегистрируйтесь и добавьте первую проверку — первый инцидент в журнале появится сам.