Медленный TTFB: причины и как ускорить
Что такое TTFB и из чего он складывается
TTFB (Time To First Byte, «время до первого байта») — это интервал между моментом, когда клиент отправил HTTP-запрос, и моментом, когда из сокета пришёл первый байт ответа. Важная деталь: TTFB измеряет реакцию сервера, а не скорость загрузки страницы. Если TTFB равен 400 мс, а сама страница весит 3 МБ, пользователь всё равно будет ждать: сначала сервер «думает», потом идёт передача данных.
Формула, которая помогает не путать причины местами:
TTFB = DNS-резолвинг + установка TCP + TLS-рукопожатие + ожидание сервера + первые байты бэкенда
Ключевой вывод из формулы: медленный TTFB — это не одна проблема, а сумма пяти разных. Прежде чем что-то оптимизировать, нужно понять, какой из этапов съедает время. Именно этому посвящена статья: сначала измерить и разложить по фазам, потом чинить то, что действительно виновато.
Ориентиры (для обычных контентных сайтов и лендингов; для API-эндпоинтов требования строже):
| TTFB | Оценка | Что обычно означает |
|---|---|---|
| до 200 мс | отлично | сервер и сеть в порядке, есть кэш или CDN |
| 200–500 мс | приемлемо | типично для динамического сайта без сильного кэша |
| 500–1000 мс | медленно | заметно для пользователя, есть что чинить |
| больше 1000 мс | проблема | бэкенд, БД или сеть работают плохо |
| больше 3000 мс | критично | страница рискует не дождаться пользователя, а бот-проверка — зафиксировать сбой |

Три разных TTFB, которые легко перепутать
Одна из главных причин путаницы: под «TTFB» в разных инструментах понимают разные вещи. Разведите их сразу.
1. Сетевой TTFB (сеть + TLS)
Это время, которое запрос физически едет до сервера и обратно, плюс рукопожатия. Зависит от географии, качества маршрутов, загрузки канала. Сайт может быть идеально оптимизирован, но если сервер стоит в одном регионе, а посетители в другом, TTFB будет высоким у всех, кроме «соседей».
2. Серверный TTFB (обработка запроса)
Сколько времени приложение тратит от получения запроса до отдачи первого байта: генерация HTML, запросы к базе, вызовы внешних API, рендеринг шаблонов. Это самая частая причина «плавающего» TTFB, когда сайт то летает, то висит.
3. TTFB из точки замера
Ваш ноутбук в Москве и замер из другого дата-центра покажут разные числа. Поэтому одиночный замер в браузере почти бесполезен для диагностики: он не отделяет «медленный сервер» от «медленный маршрут до сервера».
Практический вывод: замерять нужно с независимой внешней точки и регулярно, а не разово с рабочей машины. Разовую проверку скорости и TTFB можно сделать в проверке скорости UptimeChecker — она покажет время ответа так, как его видит внешний клиент.
Измеряем TTFB правильно: curl с -w и построчный разбор
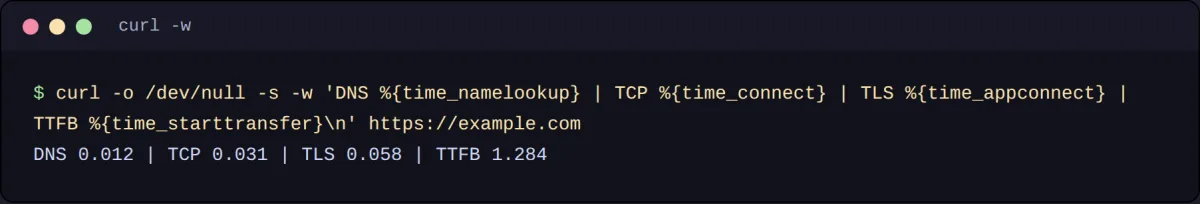
Самый честный бесплатный инструмент диагностики — curl с форматом вывода -w (write-out). Он возвращает не итоговое число, а разложение по фазам.
curl -o /dev/null -s \
  -w "dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s ttfb=%{time_starttransfer}s total=%{time_total}s http=%{http_code}\n" \
  https://uptimechecker.ru/
Что делает каждая часть команды:
-o /dev/null— выбрасываем тело ответа, нам нужны только метрики;-s— тихий режим, без прогресс-бара, чтобы вывод был одной строкой;-w "..."— шаблон вывода метрик;\nв конце даёт перевод строки;%{time_namelookup}— момент завершения DNS-резолвинга (в секундах от старта);%{time_connect}— момент завершения TCP-рукопожатия;%{time_appconnect}— момент завершения TLS-рукопожатия (для HTTPS);%{time_starttransfer}— момент получения первого байта тела ответа, это и есть TTFB;%{time_total}— полное время операции;%{http_code}— HTTP-статус, чтобы не измерять скорость отдачи страницы-ошибки.
Пример вывода:
dns=0.012345s connect=0.028901s tls=0.076543s ttfb=0.412876s total=0.498231s http=200
Как это читать — считаем не абсолютные значения, а дельты между фазами:
| Метрика | Значение | Дельта к предыдущей фазе | Что означает |
|---|---|---|---|
dns |
0.012 с | 0.012 с | DNS-резолвинг быстрый, кэш резолвера работает |
connect |
0.029 с | 0.017 с | TCP-рукопожатие, нормально |
tls |
0.077 с | 0.048 с | TLS-хендшейк, приемлемо (есть куда улучшать) |
ttfb |
0.413 с | 0.336 с | вот здесь основная задержка: сервер «думает» 336 мс |
total |
0.498 с | 0.085 с | передача тела ответа |
Главный навык: вычитать. В этом примере 336 мс из 413 мс TTFB — это ожидание сервера, а не сеть. Оптимизировать сеть или ставить CDN бессмысленно: узкое место — бэкенд.
Как считать дельты одной командой, без калькулятора:
curl -o /dev/null -s -w "dns   %{time_namelookup}\ntcp   %{time_connect}\ntls   %{time_appconnect}\nttfb  %{time_starttransfer}\ntotal %{time_total}\n" \
  https://uptimechecker.ru/
И усреднение по нескольким запускам — одиночный замер врёт из-за прогрева и случайных сетевых всплесков:
for i in 1 2 3 4 5; do
  curl -o /dev/null -s -w "%{time_starttransfer}\n" https://uptimechecker.ru/
done | awk '{s+=$1; n++} END {printf "средний TTFB: %.3f с по %d замерам\n", s/n, n}'
Пояснение к обработке: awk суммирует все числа в первой колонке (s+=$1), считает их количество (n++) и в блоке END печатает среднее. Пять замеров — минимум; для «плавающих» проблем запускайте не меньше десяти и смотрите на разброс, а не только на среднее.
Полезные HTTP-заголовки для диагностики
Если сервер отдаёт заголовки времени обработки — вы выиграли диагностику без доступа к серверу:
curl -sS -D - -o /dev/null https://example.com/ | grep -i -E 'server-timing|age|x-cache|cf-cache-status|via'
Разбор вывода:
Server-Timing: db;dur=53, app;dur=47.2— сервер сам сообщил, что 53 мс ушли на базу, 47 мс на приложение; если здесь сотни миллисекунд, проблема точно в бэкенде;Age: 62— ответ отдан из кэша, ему 62 секунды; значит, TTFB зависит не от генерации страницы, а от сети до кэширующего узла;X-Cache: HIT/X-Cache: MISS— попали в кэш или нет; повторная проверка сMISSпревратится вHIT, и TTFB упадёт;Via— запрос прошёл через прокси или CDN, что объясняет часть задержки;cf-cache-status, если используется внешний прокси-слой, показывает статус кэша на его стороне.
Диагностика по слоям: где именно теряется время
Медленный TTFB стоит разбирать по слоям, от самого клиента к самому серверу. Проверяйте по порядку: так вы не будете оптимизировать то, что не виновато.
Слой 1. DNS
dig +stats example.com A
Пояснение к выводу: смотрите на строку ;; Query time: 34 msec и на блок SERVER:. Если Query time стабильно больше 100–150 мс, а SERVER — это медленный публичный резолвер, часть TTFB теряется ещё до соединения. Проверьте записи A/AAAA и TTL в проверке DNS. Отдельно смотрите на AAAA: если у сайта есть IPv6-запись, но IPv6 маршрутизируется плохо, часть клиентов будет платить за «слепую» попытку IPv6.
Слой 2. TCP и TLS
curl -s -o /dev/null -w "connect=%{time_connect} tls=%{time_appconnect}\n" https://example.com/
Если time_connect большой, а сервер расположен далеко от клиента — это география. Если большой разрыв между connect и appconnect, проблема в TLS: старый протокол, отсутствие session resumption, тяжёлые сертификатные цепочки, отсутствие OCSP stapling. Проверить состояние сертификата и цепочки можно в проверке SSL.
Слой 3. Приложение
Здесь чаще всего и живёт «медленный TTFB». Типовые виновники:
- запросы к базе без индексов и с
SELECT *; - N+1 запросы, когда на каждую запись каталога идёт отдельный запрос;
- синхронные вызовы внешних API прямо в рендере страницы;
- отсутствие opcache/кэша шаблонов;
- холодный старт после деплоя, когда кэш пуст;
- тяжёлые плагины и «шумные» хуки в CMS;
- отсутствие кэширования ответа там, где контент не меняется каждую секунду.
Слой 4. Инфраструктура
- сервер упирается в CPU или в лимит воркеров (например, PHP-FPM или пул приложения), запросы стоят в очереди;
- узкий канал и «шумные соседи» на VPS;
- проверки WAF и антибот-фильтров добавляют задержку до попадания запроса в приложение;
- отсутствие кэширующего слоя перед бэкендом;
- дисковые операции: медленный диск даёт «рваный» TTFB под нагрузкой.
Таблица «симптом → причина → решение»
Практический чек-лист, с которым можно идти к результату без перебора всех гипотез.
| Симптом / код в выводе | Вероятная причина | Что делать |
|---|---|---|
time_namelookup > 0,15 с |
медленный DNS-резолвер или много CNAME | сократить цепочку CNAME, перейти на быстрый авторитативный DNS, проверить записи через /dns-check |
time_connect > 0,2 с |
далёкая география, плохой маршрут | разместить узел или кэширующий слой ближе к аудитории |
time_appconnect сильно больше time_connect |
тяжёлый TLS-хендшейк, нет resumption | включить TLS 1.3, session tickets, OCSP stapling, HTTP/2; проверить цепочку сертификата |
ttfb > 1 с при быстрых connect и tls |
медленный бэкенд, БД, внешние вызовы | профилировать запросы, включить кэш, добавить индексы, убрать синхронные внешние вызовы |
| TTFB скачет от 0,3 с до 3 с | очередь воркеров, пиковая нагрузка, GC | увеличить пул, добавить кэш перед приложением, проверить метрики CPU/памяти |
| Первый замер медленный, повторный быстрый | холодный кэш, прогрев | включить прогрев кэша после деплоя |
| TTFB высокий только у части пользователей | маршруты, IPv6, региональные провайдеры | замеры из разных точек, включить раздачу контента через несколько узлов |
http=429 или http=503 при быстром соединении |
лимиты, rate limiting, перегрузка | разобрать лимиты приложения и прокси, проверить коды ответа внешней проверкой |
| TTFB высокий только по HTTPS, по HTTP нормальный | TLS-слой не оптимизирован | включить современный протокол и резюмирование сессий, проверить /ssl-check |
Отдельно про 504: если медленный TTFB заканчивается ошибкой шлюза, разбор причин — в статье HTTP 504 Gateway Timeout: причины и что делать. Таймаут шлюза почти всегда является следствием того же самого «медленного бэкенда», только доведённого до предела.
Как ускорить TTFB: что даёт эффект, что бесполезно
Что реально работает
- Кэш перед приложением. Полностраничный кэш или кэш ответа API убирает цикл генерации страницы целиком. Самая быстрая победа там, где контент меняется не каждую секунду.
- Профилирование медленных запросов. Включите лог медленных запросов базы и найдите 3–5 самых тяжёлых. Обычно один неоптимальный запрос отвечает за 30–50% серверного TTFB.
- Развязка внешних вызовов. Любой вызов стороннего API внутри рендера страницы добавляет свой латентный «хвост» к TTFB. Выносите в фон, кэшируйте, ставьте таймаут.
- Прогрев после деплоя. Пустой кэш после релиза — классическая причина «после обновления сайт тормозит пару минут».
- Современный TLS и HTTP/2. Сокращает фазу
appconnect, особенно на мобильных сетях с высоким RTT. - Уменьшение размера ответа и первых байтов. Чем меньше HTML и чем раньше начинается отдача, тем меньше
totalи тем меньше времени до первого байта у пользователя.
Что часто делают зря
- Ставят CDN, когда узкое место — бэкенд, а
ttfbрастёт при быстрыхconnectиtls. Кэширующий слой не поможет, если он всё равно идёт к медленному серверу. - Оптимизируют картинки и CSS в надежде исправить TTFB. Это влияет на общее время загрузки, но не на время до первого байта.
- Гонят сжатие на уже быстрых ответах: экономия на передаче может быть меньше, чем стоимость сжатия на слабом CPU.
- Наращивают мощность сервера, не посмотрев в лог медленных запросов: проблема часто в одном запросе, а не в железе.
Как поставить мониторинг TTFB, а не замерять руками
Главная проблема ручных замеров — они делаются один раз, в момент, когда уже что-то сломалось. А TTFB — величина изменчивая: она растёт ночью при бэкапах, на пике нагрузки, после деплоя, при деградации у провайдера.
Рабочая схема:
- зафиксируйте базовое значение TTFB в нормальном режиме — лучше усреднённое по нескольким точкам;
- настройте регулярную внешнюю проверку скорости и времени ответа, чтобы видеть отклонения, а не факт падения;
- держите под наблюдением SSL-сертификат и срок его действия — истёкший или деградировавший TLS сам по себе поднимает TTFB, а иногда выглядит как «сайт тормозит»;
- смотрите на доступность отдельно от скорости: сайт может отвечать с кодом 200 и медленно, а может отдавать ошибку быстро — это разные инциденты.
Для регулярного контроля времени ответа и TTFB из внешней точки подойдёт проверка скорости на UptimeChecker: она показывает, как страницу видит внешний клиент. Дополнительно держите в поле зрения общий статус доступности через проверку сайта и крайние значения — цельтесь не в «средний TTFB», а в стабильность: узкий разброс важнее красивого среднего.
Частые ошибки при разборе TTFB
- Измерять из браузера, а не внешней командой. Кэш браузера, расширения и ваша локальная сеть сильно искажают картину.
- Делать один замер. TTFB нужно мерить серией и смотреть распределение.
- Путать TTFB с полным временем загрузки. Медленная отдача больших файлов — это не медленный TTFB.
- Проверять кэшируемый ответ. Повторный запрос из кэша покажет красивое число и спрячет реальную проблему: замеряйте и «холодный», и «горячий» вариант.
- Игнорировать регион замера. Сравнивайте числа из тех регионов, где живут ваши пользователи.
Итог
Медленный TTFB почти никогда не лечится «в общем». Сначала разложите время по фазам через curl -w, посмотрите на дельты, и только потом оптимизируйте тот слой, который действительно съедает миллисекунды: DNS, TLS, приложение или инфраструктуру. Инструменты для этого — curl, dig и внешние проверки вроде speed-check — дают полную картину без доступа к серверу.
Если вам нужно держать скорость ответа под контролем постоянно, а не раз в квартал, посмотрите на мониторинг UptimeChecker: помимо базовой доступности он проверяет скорость, SSL и домены, а значит, изменения TTFB видно до того, как о них напишут пользователи.


