Статус-страница: что это, кому нужна и какую проблему решает
Что такое статус-страница
Статус-страница — это публичная страница по отдельному адресу, на которой видно, работают ли сервисы прямо сейчас и как они работали последний месяц. Заходят на неё не из любопытства: её открывают, когда что-то уже сломано и нужно понять, что именно и надолго ли.
Внутренний мониторинг и статус-страница решают разные задачи, хотя и питаются одними данными:
- Мониторинг отвечает на вопрос «знаем ли мы». Проверка падает, приходит письмо, инженер берётся за разбор. Всё это происходит внутри.
- Статус-страница отвечает на вопрос «знает ли клиент и знает ли он то же, что мы». Человек приходит, видит состояние сервисов, историю за 30 дней и ленту инцидентов — и не пишет в поддержку «у меня одного не открывается?».
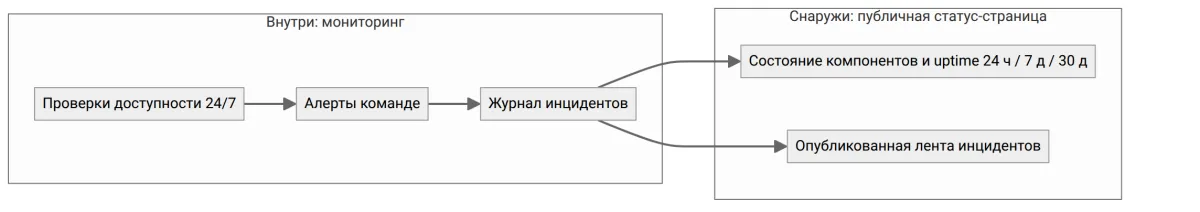
В UptimeChecker статус-страница — это отдельная страница на адресе status.uptimechecker.ru/{slug}. Она не требует ни отдельного домена, ни разработки: её собирает сервис из тех проверок, которые вы на неё добавили.
Какую проблему она решает
Проблема, ради которой заводят статус-страницу, почти никогда не в том, что «пользователи не знают о падении». Проблема в объёме объяснений, который на тебе весит после каждой аварии.
Молчание дороже простоя
Самый дешёвый способ потерять доверие клиента — молчать. Пока сервис лежит, клиент накручивает себе сценарии: «сайт сломан насовсем», «нас не поддерживают», «в том году тоже было, а мы платим». Через три часа вы отвечаете «уже смотрим», и клиент справедливо замечает: значит, три часа никто не смотрел.
Статус-страница переводит разговор из «что у вас происходит» в «когда почините». Это разные вопросы, и второй в разы спокойнее.
Один источник правды вместо переписки
Когда состояние сервисов живёт только в чатах и письмах, у каждой стороны своя версия событий. Классическая ситуация: вы говорите «сервис лежал 10 минут», клиент уверен, что «полдня». Победителя в таком споре нет, потому что нет данных, которые обе стороны признают.
Публичная страница с историей доступности за 24 часа, 7 и 30 дней прекращает этот спор: обе стороны смотрят на одну и ту же полоску и видят одну и ту же цифру.
Объяснение причин перестаёт быть разовой работой под давлением
Пока журнала нет, каждая авария — это импровизация: писать или не писать, куда писать, что писать. С журналом у вас есть заготовленный путь: запись появилась, статус сменился на «разбираемся», потом на «причина найдена», затем «устранено» с указанной причиной. Клиент видит движение — и не требует ежеминутного отчёта.
Статус-страница помогает на этапе продажи
Для агентства и студии это ещё и инструмент отстройки. В коммерческом предложении строка «у ваших проектов будет статус-страница: клиенты видят состояние, историю и разбор каждой аварии» читается конкретнее, чем «мы обеспечим поддержку 24/7». Проверить первую фразу можно за один клик, вторую — нельзя никак.
Полезно смотреть на статус-страницу в связке с SLA: страница — это способ доказывать выполнение обязательств. Как считать допустимый простой и что фиксировать в договоре, разобрано в материале «SLA на поддержку сайта: шаблон для агентства».
Кому она нужна, а кому — нет
Честный ответ: статус-страница нужна не всем. Есть случаи, где она бессмысленна, и это стоит понимать до того, как заводить.
| Кому | Нужна? | Почему |
|---|---|---|
| AI-агентства и digital-студии с несколькими клиентскими проектами | Да | Одна страница прощает весь объём объяснений по инциденту; понятный аргумент в продаже поддержки |
| SaaS-сервисы и внутренние продукты | Да | Пользователи работают в сервисе ежедневно, любая недоступность для них — блокер |
| Магазины и сервисы с оплатой | Да | Простой в момент заказа — прямые деньги, клиенту важно видеть, что проблема на стороне сервиса, а не его карты |
| Проекты с формальным SLA | Да | Страница и журнал — объективные данные для отчёта о доступности |
| Лендинг без личной регистрации, визитка, сайт «для галочки» | Скорее нет | Никто не заходит проверять, «работает ли ваша визитка»; стоимость внимания на поддержку выше пользы |
| Внутренние сервисы под NDA | Нет | Публичный адрес и публичные имена компонентов противоречат самой идее закрытого контура — здесь хватает алертов |
| Проект, где падений почти не бывает | Спорно | Пока аварий нет, страница простаивает; но именно она делает редкую аварию безобидной в глазах клиента |
Общее правило простое: статус-страница окупается там, где у сервиса есть пользователи, у которых есть ожидания по доступности. Если ожиданий нет, нечего и подтверждать.
Что показывает публичная статус-страница
Публичная часть устроена намеренно консервативно: чем меньше на ней можно перепутать и чем меньше она выдаёт о внутреннем устройстве, тем лучше.
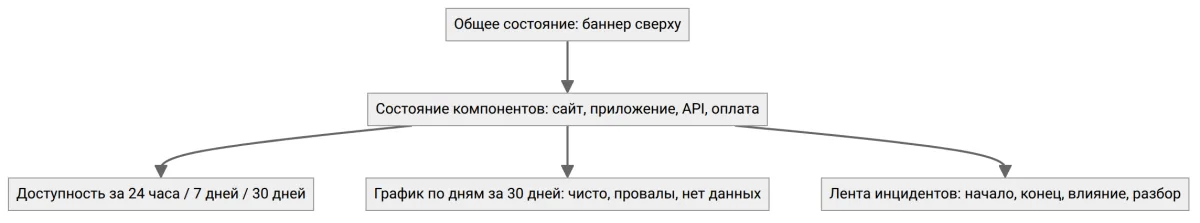
- Общее состояние. Баннер сверху: либо «всё работает», либо заметное предупреждение о том, что часть сервисов недоступна или работает нестабильно. Если хоть один компонент недоступен, страница не имеет права выглядеть благополучно.
- Состояние компонентов. Каждая добавленная проверка — отдельный компонент со своим статусом. Компонент — это ровно то, что вы решили показать: сайт, приложение, API, форма оформления заказа, оплата.
- Доступность за 24 часа, 7 дней и 30 дней. Три цифры рядом с компонентом: как быстро видно «прямо сейчас» и как видно «в масштабе месяца». Кратковременный сбой, который легко пропустить, в месячной цифре уже заметен.
- График по дням за 30 дней. Полоска из баров, по одному на каждый день: зелёный — день прошёл чисто, оранжевый и красный — были провалы, серый — за сутки данных нет и утверждать благополучие нечем. День рисуется серым, а не зелёным, потому что «нет данных» и «всё хорошо» — разные утверждения.
- Лента инцидентов. Опубликованные записи о том, что ломалось: когда началось, когда закончилось, насколько повлияло и что с этим делали.
Чего на статус-странице нет и почему
Отдельно стоит сказать о том, что на публичную страницу не попадает, — это не недоделка, а решение.
Частота проверок не показывается
На публичной странице нет интервала проверок: ни подписью, ни в подсказке, ни косвенно. Это осознанное решение. Интервал — предмет тарифа: на бесплатном тарифе проверки идут реже, на Pro — чаще, и публиковать эту разницу на странице для клиента значит раскрывать внутреннюю кухню вашего обслуживания.
Чтобы интервал не просачивался косвенно, страница отдаёт бары по дням только как «дата и процент доступности». Число проверок за сутки там не выводится — по нему интервал восстанавливается в одно действие: полторы тысячи проверок в сутки означают проверку раз в минуту. Поэтому рядом с компонентом видны только три цифры uptime и полоска дней, а не количество замеров.
Внутренние имена проверок не уходят наружу
Внутреннее имя проверки, которое вы давали «для себя» — со словом тест, стенд, «не трогать», номером тикета — на публику не попадает. Для каждого компонента задаётся публичное имя: на странице клиента будет «Оформление заказа», а не «prod-shop-checkout-form (v2)». Это не косметика: внутренние имена выдают и структуру, и ваши внутренние названия, и то, каких проектов у вас сколько.
Журнал инцидентов: влияние, разбор, хроника
Одна страница с текущим состоянием отвечает на вопрос «что сейчас», но не отвечает на вопрос «насколько это было серьёзно». Для этого нужен журнал.
У записи об инциденте есть:
- Начало и конец. Время фиксируется по факту, а не «примерно в обед».
- Влияние: нет, незначительное, существенное, критичное. Это то, что клиент читает первым: баннер «существенное» и «незначительное» — два совсем разных разговора.
- Статус разбора. «Разбираемся» → «причина найдена» → «следим» → «устранено». У закрытой аварии состояние «устранено» видно сразу и отдельно от влияния — иначе завершённый инцидент выглядит так же, как идущий, и клиент не понимает, закончилось ли.
- Причину. Заполняется при закрытии. Причина обязательна: журнал без причин превращается в список «что-то падало», из которого невозможно сделать выводы и невозможно показать клиенту, что проблема понята.
- Хронику обновлений. Короткие записи по ходу разбора, в том же порядке, в каком они появлялись. Именно хроника убеждает лучше любых обещаний: видно, что никто не молчал.

Запись можно опубликовать на статус-странице, а можно оставить внутренней. Внутренние записи остаются в кабинете: вы ведёте полный журнал, включая то, что наружу показывать не нужно.
Три правила, из-за которых страница не превращается в утечку
Если статус-страница одна, а клиентов много, самая дорогая ошибка — показать клиенту А аварию клиента Б. Поэтому в основе лежат жёсткие правила.
- Инцидент без привязки к проверке наружу не выходит никогда. Даже если у записи стоит отметка «опубликовано», без монитора она публичной не становится. Флаг публикации сам по себе силы не имеет.
- На странице клиента видны только инциденты тех проверок, которые на неё добавлены. Лента страницы — это пересечение состава страницы и журнала. Ничего «рядом лежащего» в неё не попадает.
- Состав страницы вы задаёте сами. Список компонентов и их порядок определяют, что вообще увидит посетитель.
Из этого следует и приятный побочный эффект: одну и ту же проверку можно добавить в несколько статус-страниц. Например, общий API может быть компонентом и на странице «Магазин», и на странице «Мобильное приложение» — показываете вы его там со своим публичным именем в каждом случае.
Черновики аварий от мониторинга
Вести журнал вручную — самая частая причина, по которой журналы не ведут: пока разбираешься с аварией, писать о ней некогда, а потом уже «неактуально».
В UptimeChecker этого не требуется. Когда проверка падает, запись в журнале создаётся автоматически — с реальным временем начала аварии, а не с моментом, когда кто-то открыл кабинет. Когда сервис восстановился, запись так же автоматически закрывается.
Ключевая деталь: автоматическая запись остаётся черновиком. Наружу она не выходит, пока её не опубликует человек. Причину тоже вписывает человек — автоматика её не выдумывает и не подставляет «что-то с сетью». Логика простая: показать клиенту «мы разбираемся» полезно, а показать «причина: неизвестна» вредно. Между аварией и публикацией должна стоять голова, которая понимает, что произошло.
Практический эффект — журнал ведётся сам, а ваша работа сводится к двум коротким действиям: указать причину и нажать «опубликовать».
Плановые работы: помечаем, но не прячем простой
Плановые работы — это регламентное обновление, переезд, миграция, которые вы делаете сами и о которых можно предупредить.
В журнале они помечаются отдельно: посетитель видит, что это не авария, а запланированное вмешательство. Это честно по отношению к клиенту и снимает лишнюю тревогу.
Но есть важное правило, о котором стоит помнить: пометка «плановые» не влияет на расчёт uptime. Если сервис был недоступен, простой считается — независимо от того, сами вы его уронили или он упал сам. У uptime один источник: результаты проверок. Ни плановая пометка, ни снятие записи с публикации, ни незаполненная причина не могут задним числом улучшить статистику. Поэтому цифры на странице и цифры в журнале не могут разъехаться — они считаются по одному и тому же набору проверок.
Как завести страницу
Порядок занимает считаные минуты:
- Добавьте проверки, которые хотите показывать. Статус-страница собирается из уже работающих проверок — отдельных настроек для публичного контура не нужно.
- Создайте страницу в кабинете и задайте её адрес (
slug). Адрес генерируется из названия, точное значение видно рядом с кнопкой копирования. - Отметьте состав и порядок компонентов: какие проверки на странице и в каком порядке они идут.
- Задайте публичные имена каждому компоненту — то, что прочитает посетитель.
- Опубликуйте страницу. До публикации адрес не работает, и это правильно: черновик страницы наружу не отдаётся.
- Ведите журнал: аварии фиксируются сами, от вас — причина и кнопка «опубликовать».
Перед публикацией стоит один раз проверить адрес руками — если он не отвечает даже для вас, статус-страница лишь покажет всем ту же ошибку. Быстрый набор из трёх команд закрывает главные вопросы: curl -I показывает код ответа и редиректы, dig +short — куда вообще разрешается домен, openssl s_client — не истёк ли сертификат. Запускать их логично с того же контура, откуда потом будет проверять сервис, иначе результат будет отличаться.
curl -I https://example.ru
dig +short example.ru
openssl s_client -connect example.ru:443 -servername example.ru -noout -dates < /dev/null
По тарифам: на бесплатном тарифе доступна одна статус-страница, и на ней остаётся копирайт сервиса. На Pro (299 ₽/мес) — до десяти страниц, и копирайт можно отключить. Учитывая, что страниц обычно нужно по одной на клиента, Pro закрывает агентство с десятком проектов; бесплатной одной страницы хватает, чтобы начать.
Частые ошибки
| Ошибка | К чему приводит | Как правильно |
|---|---|---|
| Публиковать состояние, но не вести журнал | Ссылка есть, доверия нет: непонятно, что было и как закончилось | Включить авто-черновики и закрывать аварии причиной |
| Оставлять внутренние имена компонентов | Наружу утекает структура проектов и внутренние названия | Задавать публичное имя каждому компоненту |
| Прятать плановые работы или выдавать аварию за плановые | Один раз заметят — и цифрам перестанут верить | Помечать плановые отдельно, но простой считать |
| Завести одну страницу на все проекты клиентов | На странице клиента А видно аварию клиента Б | Отдельная страница на проект, своя выборка проверок |
| Публиковать авто-запись как есть | В ленте висит «причина неизвестна», клиент додумывает худшее | Писать причину и публиковать осознанно |
| Ставить на страницу нестабильную проверку с флапами | Ложные тревоги на публике хуже отсутствия страницы | Убедиться в стабильности проверки до публикации |
Отдельно про ложные тревоги: публичная страница усиливает любую ошибку мониторинга. Внутренний ложный алерт — это лишнее письмо инженеру, публичный ложный алерт — это «сервис недоступен» на глазах у клиента. Поэтому состав публичной страницы стоит собирать из проверок, которым вы доверяете.
Коротко о главном
Статус-страница — не украшение лендинга, а инструмент снижения цены инцидента. Она решает три задачи: снимает с команды поток вопросов «что происходит», заменяет споры о длительности простоя общей цифрой и показывает клиенту, что каждая авария разобрана до причины.
Что стоит помнить:
- Публично показывается состояние компонентов, uptime за 24 часа / 7 и 30 дней, бары по дням и опубликованные инциденты.
- Интервал проверок и внутренние имена компонентов на публику не уходят — это осознанное решение, а не пробел.
- Инцидент без проверки наружу не выходит никогда, а на странице клиента видны только инциденты её компонентов.
- Черновики аварий создаются и закрываются сами, но публикует и объясняет человек.
- Плановые работы помечаются отдельно и не влияют на расчёт uptime.
Начать можно без вложений: бесплатный тариф включает одну статус-страницу и мониторинг трёх сайтов с девятью проверками — этого достаточно, чтобы показать клиенту состояние проекта и вести журнал по-настоящему, а не «когда будет время». Оценить допустимый простой для своих обязательств удобно на калькуляторе доступности, а сколько времени сервис был недоступен за последний месяц, покажет история проверок в кабинете.
Если вы ещё не начинали с мониторинга — посмотрите материалы «Почему падают сайты: 12 главных причин» и «SLA 99.9%: сколько это времени простоя на самом деле»: с ними понятнее, какую цифру доступности вообще имеет смысл обещать клиенту.