SLA 99.9%: сколько это времени простоя на самом деле
Что такое SLA и почему его путают с uptime
SLA (Service Level Agreement) — это соглашение об уровне сервиса между провайдером и клиентом. В нём фиксируют целевой показатель доступности, например 99.9%, и описывают последствия, если провайдер его не выдержит: обычно это кредиты, скидка или перерасчёт оплаты за период.
Прежде чем разбирать цифры, стоит разделить два понятия, которые регулярно смешивают даже в профессиональных обсуждениях:
- Uptime (доступность) — фактический, измеренный показатель. Он отвечает на вопрос: какую долю времени за отчётный период сервис отвечал корректно. Это факт, который можно посчитать по журналу мониторинга.
- SLA — это обещание, целевое значение, которое провайдер обязуется обеспечить. Это условие договора, а не измерение реальности.
Отсюда простой вывод: «SLA 99.9%» означает не «сервис работает хорошо», а «провайдер обещает, что за период услуга будет недоступна не более чем определённое число минут». Сама цифра 99.9% — это не качество, а зашифрованный пересчёт допустимого простоя в проценты.
Главное заблуждение, из-за которого люди выбирают не тот тариф: разница между 99.9% и 99.99% — не одна десятая процента, а целый порядок. Это ровно десять раз по времени простоя: около 8 часов 45 минут против 52 минут в год. Дальше покажем, откуда берутся эти числа.
Пересчитываем проценты в минуты: точная таблица
Проценты удобны в договорах, но плохо ощущаются. Чтобы понять, что за ними стоит, нужно перевести долю недоступности в конкретные минуты и часы.
Формула пересчёта простая: берём длительность периода, считаем долю недоступности (100% минус уровень SLA) и умножаем.
Год = 365 дней = 8 760 часов = 525 600 минут. Доля недоступности для уровня 99.9% — это 0.1%, или 0.001 от целого. Перемножаем: 525 600 × 0.001 = 525.6 минуты, то есть 8 часов 45 минут 36 секунд.
| Уровень SLA | Простой в год | Простой в месяц (30 дней) | Простой в неделю | Простой в день |
|---|---|---|---|---|
| 99.9% | 8 ч 45 мин 36 с | 43 мин 12 с | 10 мин 5 с | 1 мин 26 с |
| 99.95% | 4 ч 22 мин 48 с | 21 мин 36 с | 5 мин 2 с | 43 с |
| 99.99% | 52 мин 34 с | 4 мин 19 с | 1 мин 0.5 с | 8.6 с |
| 99.999% | 5 мин 15 с | 26 с | 6 с | 0.9 с |
Несколько наблюдений, которые видны только из таблицы:
- Один «девятый» знак — десятикратная разница. Каждый следующий уровень ровно в десять раз жёстче по допустимому простою.
- 99.9% — это «полноценная» авария раз в квартал. 43 минуты в месяц — это не редкий сбой, а целый рабочий час простоя в среднем каждый месяц.
- 99.99% уже требует серьёзной инженерии. 52 минуты в год означают, что даже одна плановая остановка на час уже «съедает» весь годовой бюджет простоя.
- 99.999% («пять девяток») — это считанные секунды в день. Такой уровень в вебе достигается только с резервированием, автоматическим переключением и отказоустойчивой архитектурой.
Если вы хотите посчитать свой сценарий — например, сколько простоя «стоит» ваш тариф при заданном SLA или наоборот, какой уровень вам нужен при конкретном допустимом простое — удобнее не считать вручную, а использовать калькулятор доступности UptimeChecker: он переводит проценты в минуты и обратно за секунду.
Почему 99.9% на практике оказывается больше, чем кажется
Проблема процентов в том, что мозг воспринимает 99.9% как «почти идеально». Разница в 0.1% звучит пренебрежимо мало — но на шкале времени она превращается в часы, причём именно тогда, когда это больнее всего.
Вот три причины, по которым 99.9% обманчиво:
-
Простой не распределяется равномерно. Формула предполагает, что 43 минуты в месяц «размазаны» по 86 секундам в день. В реальности доступность теряется рывками: одна ночная авария на 40 минут покрывает весь месячный лимит. Среднее значение скрывает реальную боль — пользователь, попавший на сбой, не знает, что остальные 30 дней всё работало.
-
Накопление идёт в часы пик. Аварии чаще случаются при росте нагрузки — в момент, когда трафик и выручка максимальны. 43 минуты простоя в прайм-тайм стоят несопоставимо дороже, чем те же 43 минуты ночью. Поэтому сравнивать SLA по «голым минутам» некорректно — важно ещё и когда они выпадают.
-
Каждый сбой — это не только время. После восстановления наступает «хвост»: нагрузка на поддержку, отток пользователей, удар по позициям в поиске, если бот обходил сайт в момент сбоя. Реальная цена минуты простоя больше, чем прямая потеря выручки за эту минуту.
Отдельно стоит сказать про время обнаружения и реакции. SLA описывает только итоговую недоступность, но не то, как быстро её заметят. Если мониторинг проверяет сайт раз в 5 минут, то сбой, который длился 40 секунд, вы просто не увидите — а это уже весь дневной бюджет уровня 99.99%. Чем чаще проверка, тем точнее ваша картина реального uptime и тем меньше «слепых зон».
Как один инцидент «съедает» годовой бюджет
Цифры из таблицы выше проще всего прочувствовать через обратный пример: возьмите целевой уровень 99.9% и посмотрите, какие единичные события уже покрывают весь допустимый простой.
| Событие | Типичная длительность | Сколько месячного лимита 99.9% «съедает» |
|---|---|---|
| Краткий всплеск нагрузки | 5–10 минут | До четверти месячного бюджета (43 мин) |
| Перезапуск базы данных с восстановлением | 15–25 минут | Треть или половину бюджета |
| Неудачный деплой с откатом | 30–60 минут | Весь месячный лимит за один раз |
| Авария у хостинг-провайдера | 1–4 часа | Превышает лимит в разы |
Из таблицы видно главное: при уровне 99.9% одна-единственная неудачная операция способна исчерпать весь месячный бюджет простоя. Это значит, что «девятки» в SLA описывают не среднюю работу сервиса, а очень жёсткий потолок на суммарное время сбоев. Поэтому «четыре» и «пять девяток» — это не про «чинить быстрее», а про то, чтобы не допускать сам факт простоя: через резервирование, автоматические откаты и отсутствие одиночных точек отказа.
От чего зависит фактическая доступность
Целевой уровень в договоре — одно, а реальный uptime складывается из десятков факторов. Полезно понимать, что именно «съедает» доступность, чтобы не строить планы на цифрах, которые инфраструктура не сможет удержать.
| Источник простоя | Что происходит | Как влияет на uptime |
|---|---|---|
| Плановые работы | Деплой, обновление БД, миграция | Даже 10-минутное окно раз в месяц — это уже 2 часа в год |
| Одиночная точка отказа | Один сервер, один провайдер, один дата-центр | Любая авария этой точки = полный простой |
| Истечение SSL-сертификата | Браузеры блокируют сайт предупреждением | Полная недоступность до продления, пока никто не заметил |
| Ошибки DNS | Неверные записи, истёкший домен | Сайт «не резолвится», фактически лежит |
| DDoS и всплески нагрузки | Ресурсы исчерпаны, сервер не отвечает | Деградация вплоть до полного отказа |
| Человеческий фактор | Ошибка конфигурации, случайный rm |
Часто — самые долгие аварии, так как их сложно диагностировать |
Каждая строка — это потенциальные минуты простоя, которые нужно вписать в годовой бюджет. Если вы обещаете клиенту 99.99% (52 минуты в год), то одна остановка базы данных на час уже превышает весь лимит. Именно поэтому «четыре девятки» и выше — это не столько про SLA в договоре, сколько про архитектуру: резервирование, балансировку, автоматические переключения и отсутствие одиночных точек отказа.
Как проверить фактическую доступность самому
Необязательно верить цифрам провайдера на слово. Базовую картину можно собрать своими средствами — хотя полноценный мониторинг с журналом инцидентов вручную не заменить.
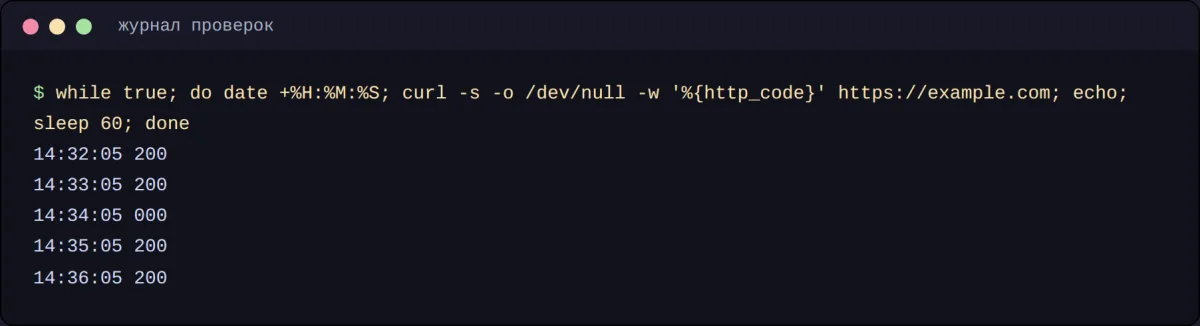
Самый простой способ — периодически проверять, что сайт отвечает кодом 200. Минимальный цикл на curl, который раз в минуту фиксирует HTTP-статус:
for i in $(seq 1 60); do
  code=$(curl -s -o /dev/null -w "%{http_code}" --max-time 5 https://example.com)
  echo "$(date '+%H:%M:%S') $code"
  sleep 60
done
Разберём построчно:
curl -s -o /dev/null -w "%{http_code}"— делает запрос, отбрасывает тело ответа (-o /dev/null) и печатает только HTTP-код (-w).--max-time 5— ограничивает ожидание пятью секундами: если сервер завис, запрос не будет висеть вечно, а оборвётся и запишется как сбой.echo "$(date '+%H:%M:%S') $code"— выводит время и код, чтобы потом по журналу восстановить картину.sleep 60— пауза в минуту между проверками.
Прогнав такой цикл сутки, вы получите 1 440 записей. Посчитайте, сколько из них не «200» — это и есть грубая оценка недоступности за период. Например, 2 сбоя из 1 440 проверок — это 2 / 1440 ≈ 0.14% простоя, то есть ниже уровня 99.9% уже за сутки.
Проверить, что сертификат не «съест» доступность, можно одной командой через openssl:
echo | openssl s_client -servername example.com -connect example.com:443 2>/dev/null \
  | openssl x509 -noout -dates
В выводе две строки — notBefore (начало действия) и notAfter (конец). Если notAfter наступает через неделю, а автоматического продления нет — планируйте обновление до того, как браузеры начнут блокировать сайт. Проверить срок в удобном виде можно и через проверку срока SSL-сертификата UptimeChecker.
Разумеется, ручной curl в цикле не заменит мониторинг: он не проверяет с разных точек мира, не отслеживает SSL и DNS, не уведомляет о сбое. Но как первичная самопроверка он даёт трезвое представление о том, насколько реальный uptime соответствует обещанному.
Что делать, если фактический uptime ниже обещанного
Допустим, вы посчитали реальную доступность и увидели расхождение с цифрой в договоре. Прежде чем писать претензию, стоит пройти по простой цепочке проверок — это сэкономит время и сделает вашу позицию обоснованной.
-
Проверьте методику. Как вы считали доступность: из одной точки или из нескольких, с каким интервалом проверок, входит ли в downtime плановое обслуживание? Если ваш расчёт и расчёт провайдера построены на разных методиках, расхождение может объясняться именно этим.
-
Убедитесь, что простой на стороне сервиса, а не у вас. Часто причиной «недоступности» оказываются собственные проблемы: истёкший SSL-сертификат, неверные DNS-записи, блокировка вашего IP. Проверьте сертификат и DNS, прежде чем обвинять провайдера.
-
Соберите доказательства. Журнал проверок с метками времени — ваш главный аргумент. Разовые наблюдения «сайт не открывался» ничего не докажут; нужен систематический лог.
-
Сравните с оговорённым порядком. В SLA обычно описан порядок фиксации простоя и подачи претензий: формы, сроки, требования к доказательствам. Действуйте по этой процедуре.
Здесь полезна именно та формула, о которой шла речь выше: пересчитайте допустимый простой для заявленного уровня, сопоставьте с фактическим и покажите расхождение в конкретных минутах. Такой расчёт воспринимается в разы серьёзнее, чем эмоциональное «у вас сайт лежал».
Как выбрать реалистичный целевой уровень
Уровень доступности — это всегда компромисс между ценой и риском. Чем больше «девяток», тем дороже инфраструктура и тем сложнее её поддерживать. Поэтому выбор стоит делать не «по красоте цифры», а от реальных потребностей.
Практическая логика выбора:
- 99.9% (8 ч 45 мин в год) — разумный ориентир для большинства сайтов и внутренних сервисов, где кратковременный простой не критичен. Достижим на обычном хостинге без сложного резервирования.
- 99.95% (4 ч 22 мин в год) — «золотая середина» для коммерческих сайтов, интернет-магазинов, личных кабинетов. Требует уже аккуратного администрирования и мониторинга.
- 99.99% (52 мин в год) — уровень платёжных и высоконагруженных систем, API для партнёров. Нужны резервирование, автопереключение и автоматизированные деплои без остановки.
- 99.999% (5 мин в год) — удел критичной инфраструктуры: биржи, телеком, системы, где каждая секунда стоит денег. Стоимость архитектуры растёт кратно, и оправдана она далеко не всегда.
Хороший практический приём: сначала оцените стоимость минуты простоя для вашего бизнеса, а уже потом подбирайте уровень. Если час простоя стоит вам 10 000 рублей, то вкладываться в «пять девяток» ради экономии пяти минут бессмысленно — дешевле заложить резерв и хороший мониторинг, чем строить отказоустойчивый кластер.
И помните: SLA — это обязательство провайдера, но вашу фактическую доступность в конечном счёте определяет ваша же инфраструктура. Даже с SLA 99.99% от хостинга вы не получите эти 99.99%, если сертификат истекает, DNS-записи неверны, а о сбоях вы узнаёте от пользователей. Поэтому независимая проверка доступности — не прихоть, а инструмент, без которого цифры в договоре остаются просто цифрами.
UptimeChecker помогает закрыть именно эту задачу: проверить доступность сайта прямо сейчас и отслеживать её изменения, чтобы сравнивать фактические цифры с обещанными. Начните с проверки доступности вашего сайта — это займёт несколько секунд и даст опорную точку для расчёта реального uptime.


