Сайт периодически падает: как поймать
Почему «периодически падает» — самый неприятный сценарий
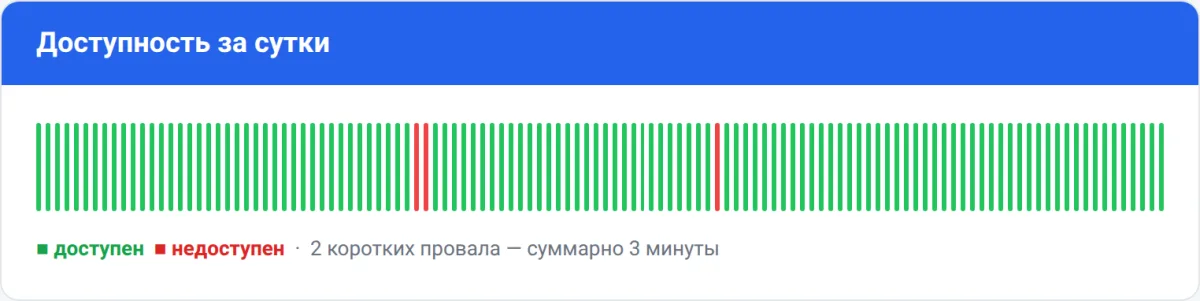
Есть два вида проблем с доступностью. Первый — сайт лёг и лежит: с этим относительно просто, причина обычно очевидна. Второй — сайт падает на минуты или секунды и снова поднимается сам, без видимых действий. Пользователь видит «то работает, то нет», а администратор в этот момент может смотреть на монитор и не замечать ничего подозрительного.
Именно периодические (интермиттентные) падения — самые коварные. Их сложно воспроизвести, потому что между сбоями сайт работает нормально. Ошибка возникает только при сочетании условий: определённое время, всплеск трафика, конкретный запрос, состояние кеша. Пока вы смотрите — всё зелёное; как отвернулись — снова красное.
Ключевая идея всей статьи: периодическое падение нельзя «поймать вручную», открывая сайт раз в час. Его ловят только непрерывным наблюдением и правильной методикой поиска — по следам, которые оставляет каждый сбой.
Прежде чем углубляться в методику, зафиксируйте отправную точку: проверьте, что сайт прямо сейчас отвечает, через проверку доступности. Если в момент проверки всё зелёное — это не отменяет проблему, а лишь подтверждает, что она периодическая.
Как проявляется периодическая недоступность
Чтобы искать причину, нужно сначала точно описать симптом. Периодические падения выглядят по-разному, и от характера сбоя зависит, куда копать.
Типичные проявления
| Что видит пользователь | Возможный характер сбоя |
|---|---|
| Сайт не открывается 1–2 минуты, потом сам оживает | Кратковременная перегрузка, рестарт процесса |
| Ошибка только в определённые часы (вечер, ночь) | Пиковая нагрузка, фоновые задачи (cron, бэкапы) |
502/504 время от времени, между ними всё ок |
Бэкенд не успевает, лимиты worker-процессов |
| Не грузится только часть страниц | Проблема конкретного маршрута/функции |
| «То работает, то нет» при обновлении | Флапающий DNS или балансировка на несколько серверов |
Почему «смотрю — всё работает»
Есть несколько причин, почему вы не видите сбой своими глазами:
- Короткая длительность. Сбой длится 30–60 секунд. Вероятность попасть на него при ручной проверке раз в час — единицы процентов.
- Привязка к условиям. Сбой возникает только при нагрузке от 200 одновременных запросов или при запуске конкретного cron-задания.
- Неравномерность. Балансировщик распределяет трафик на несколько серверов, и падает только один из них. Ваш запрос уходит на здоровый.
- География. Сбой виден только из определённого региона или сети.
Вывод: отсутствие ошибки «прямо сейчас» не означает, что её нет. Нужен непрерывный сбор данных.
Первое, что нужно сделать: подтвердить сбой
Прежде чем чинить, убедитесь, что сбой реальный, а не кажущийся. Значительная часть жалоб «сайт то работает, то нет» связана не с сервером, а с локальным окружением пользователя.
Отсекаем локальные проблемы
| Проверка | Что делает | Как трактовать |
|---|---|---|
| Открыть с другого устройства | Исключает проблему конкретного устройства | Работает на другом — проблема локальная |
| Открыть через мобильный интернет | Исключает проблему Wi-Fi/провайдера | Работает на мобильном — проблема в сети |
| Проверка извне (UptimeChecker) | Независимая точка проверки | Падает и извне — проблема реальная |
| Инкогнито/чистый кеш | Исключает кеш и cookies | Работает в инкогнито — проблема в кеше |
Первым делом проверьте сайт через проверку доступности из независимой точки. Если независимая проверка стабильно зелёная, а у пользователя «то работает, то нет» — копайте в его сторону (сеть, DNS-кеш провайдера, блокировки).
Соберите факты о сбое
Попросите того, кто заметил сбой, зафиксировать детали — они сильно сужают поиск:
- точное время сбоя;
- что именно писал браузер (код ошибки,
ERR_...); - из какой сети/устройства проверяли;
- как долго длился сбой;
- воспроизводится ли при повторной попытке.
Код ошибки — самый информативный признак. 502 указывает на бэкенд, CONNECTION_TIMED_OUT — на сеть/сервер, NXDOMAIN — на DNS. Соберите несколько эпизодов: у периодической проблемы часто бывает закономерность (например, всегда в один и тот же час).
Как поймать сбой: методика непрерывного наблюдения
Раз вручную сбой не поймать, его нужно фиксировать автоматически и непрерывно. Ниже — набор техник от простых к сложным.
1. Частый опрос с записью результата
Запустите скрипт, который опрашивает сайт каждые N секунд и пишет в лог только аномалии. Так вы получите точное время и длительность каждого сбоя.
while true; do
  code=$(curl -s -o /dev/null -w "%{http_code} %{time_total}" https://example.com)
  echo "$(date '+%F %T') $code" >> /tmp/site-check.log
  sleep 30
done
Построчный разбор:
curl -w "%{http_code} %{time_total}"— выводит код ответа и общее время запроса.>> /tmp/site-check.log— дописывает строку в лог с отметкой времени.sleep 30— интервал между проверками. Для ловли коротких сбоев уменьшите до 10–15 секунд.
Через несколько часов просмотрите лог и найдите строки с кодом не 200 и аномально большим временем:
grep -v " 200 " /tmp/site-check.log
Каждая не-200 строка — это зафиксированный сбой с точным временем. Совпадение времени сбоев с чем-то (cron, пик трафика) — уже половина разгадки.
2. Проверка из нескольких точек
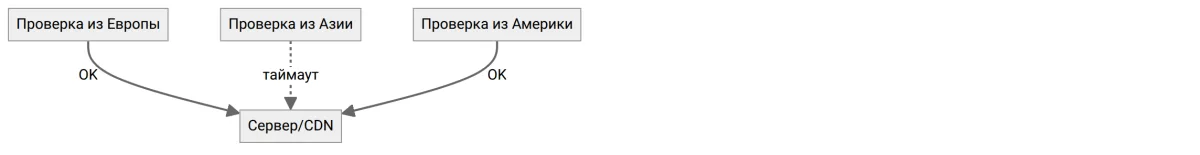
Один сервер для проверки может сам «не видеть» проблему из-за своей сети. Проверяйте сайт из разных локаций, чтобы понять, глобальный ли это сбой или локальный.
3. Логирование на стороне сервера
Пока сбой происходит, сервер пишет об этом в логи. Главное — смотреть логи именно за те минуты, когда зафиксирован сбой:
grep "$(date -d 'today 14:30' '+%d/%b/%Y:14:3')" /var/log/nginx/access.log
- Подставьте время сбоя из вашего лога проверок.
- Смотрите не только
error.log, но иaccess.log: по кодам ответа в момент сбоя видно, что происходило (рост502, резкое падение трафика и т.п.).
Типичные причины периодических падений
Теперь — о самих причинах. Периодические падения обычно связаны с одним из нескольких «плавающих» факторов.
1. Пиковая нагрузка и нехватка ресурсов
Классика: днём сайт работает, вечером (или во время акции) начинает падать. Сервер справляется со средней нагрузкой, но не с пиковой.
Признаки: сбои совпадают с пиковыми часами; во время сбоя CPU/память на максимуме; 502/504.
Как проверить. Сравните загрузку сервера в момент сбоя с обычной:
uptime
14:32:01 up 120 days, 3:15, 1 user, load average: 8.50, 3.10, 1.20
load average— средняя загрузка за 1, 5 и 15 минут. Если первое число резко выше двух других и числа ядер CPU — в момент замера был всплеск.
Сопоставьте всплески загрузки со временем сбоев из вашего лога проверок — совпадение укажет на перегрузку.
2. Исчерпание лимитов веб-сервера
Даже на мощном сервере сайт падает, если nginx/Apache упёрлись в лимиты worker-процессов или соединений. При кратковременной очереди запросов часть из них отваливается с 502.
Признаки: 502/503 короткими сериями; в логах веб-сервера сообщения о нехватке worker'ов.
Как проверить. Смотрите ошибки веб-сервера за время сбоя:
grep "502\|upstream" /var/log/nginx/error.log | tail -n 20
- Строки вида
upstream ... no live upstreamsилиconnect() failed ... too many open filesуказывают на исчерпание лимитов.
3. Фоновые задачи (cron, бэкапы)
Сайт «падает» ровно в момент, когда по расписанию запускается тяжёлое задание: ночной бэкап, импорт данных, пересборка индекса. Задание съедает все ресурсы, и на время его работы сайт не отвечает.
Признаки: сбои строго периодичны (каждый день/час в одно время); совпадают с расписанием cron.
Как проверить. Посмотрите расписание задач и сопоставьте со временем сбоев:
crontab -l
- Найдите задания, время запуска которых совпадает с зафиксированными сбоями, и временно сместите или ускорьте их.
4. Проблемы с базой данных
База может падать периодически: исчерпание пула соединений в пиках, медленные запросы, которые накапливаются, или рост размера таблиц.
Признаки: Error establishing a database connection эпизодами; рост времени ответа перед сбоем.
Как проверить. Смотрите логи СУБД и число активных соединений в момент сбоя:
mysql -e "SHOW STATUS LIKE 'Threads_connected';"
- Если число подключений в момент сбоя близко к лимиту
max_connections— причина в исчерпании пула.
5. Нестабильный DNS
DNS-проблема тоже бывает периодической: один из нескольких NS-серверов периодически не отвечает или отдаёт неверные данные, и часть запросов уходит «в никуда».
Признаки: сайт «то открывается, то нет» у разных пользователей в разное время; NXDOMAIN эпизодами.
Как проверить. Опросите DNS несколько раз подряд и сравните ответы:
for i in 1 2 3 4 5; do dig +short example.com A; sleep 1; done
- Если ответы чередуются (иногда IP, иногда пусто/другой IP) — DNS нестабилен, проверяйте NS-серверы.
6. Балансировка на несколько серверов
Если трафик распределяется между несколькими бэкендами и один из них «болеет», часть запросов падает, а часть проходит. Внешне — классическое «то работает, то нет».
Признаки: сбои случайны по времени; ошибки 502 только для части запросов; в логах балансировщика виден проблемный бэкенд.
Как проверить. Отправьте серию запросов и посмотрите, какой сервер обрабатывает каждый (по заголовку или логам):
for i in $(seq 1 10); do curl -s -o /dev/null -w "%{http_code}\n" https://example.com; done
- Если коды чередуются
200и502— классический признак проблемного узла в кластере.
7. Сетевые проблемы и маршрутизация
Периодические сетевые сбои: потеря пакетов, нестабильный канал, флапающий маршрут. Сайт при этом полностью исправен.
Признаки: сбои не привязаны к нагрузке; высокая потеря пакетов; проблема только из определённых сетей.
Как проверить. Запустите пинг с записью потерь за длительный промежуток:
ping -i 5 example.com > /tmp/ping.log &
- Через несколько часов посмотрите процент потерь и время, когда они росли. Совпадение со временем сбоев укажет на сетевую причину.
Сводная таблица: симптом → причина → решение
Соберём всё вместе. По характеру периодического сбоя можно сразу сузить круг поиска.
| Симптом | Вероятная причина | Первое действие |
|---|---|---|
| Падает в пиковые часы | Перегрузка ресурсов | Проверить load average, масштабировать |
502 короткими сериями |
Лимиты worker'ов | Поднять лимиты, смотреть error.log |
| Строго в одно время | Cron/бэкапы | Сверить crontab, сместить задачу |
| Ошибка подключения к БД эпизодами | Пул соединений БД | Проверить Threads_connected |
| Разные пользователи видят по-разному | Нестабильный DNS | Опросить DNS серией запросов |
Чередование 200/502 |
Проблемный узел в кластере | Найти бэкенд по логам |
| Потери пакетов | Сетевая проблема | Длительный ping |
| Не грузится только статика | CDN/внешний сервис | Проверить CDN-домен отдельно |
Как не пропустить следующий сбой
Ручные проверки раз в час пропускают короткие падения — это мы выяснили в начале. Поэтому периодическую проблему нужно ловить непрерывным мониторингом, который опрашивает сайт с коротким интервалом и фиксирует каждый сбой с точным временем.
Регулярная проверка доступности сайта даёт вам именно это: систематическое наблюдение вместо «поймаю, когда увижу». Зафиксировав точное время сбоя, вы дальше идёте по цепочке из этой статьи — логи, загрузка, cron, DNS — и находите причину.
Разобравшись с тем, как ловить периодические падения, полезно вернуться к более общей картине — почему сайты падают в принципе. Полный список из 12 причин, от DNS до человеческого фактора, разобран в статье о причинах падения сайтов.
Если же сайт упал полностью и не поднимается — это другой сценарий, и диагностика там строится иначе: с быстрой проверки «резолвится ли домен, открыт ли порт, жив ли сертификат». Начните с проверки доступности, чтобы понять, что именно сломалось и на каком слое.
Главное правило при периодических сбоях — не действовать вслепую. Сначала зафиксируйте факт и время, потом найдите закономерность, и только после этого меняйте конфигурацию. Одно точечное, но точное изменение приносит больше пользы, чем серия случайных «перезапусков на удачу».


