Googlebot получает 5xx: что делать
Что происходит, когда Googlebot получает 5xx
Ситуация типичная: сайт лежит или отдаёт ошибки, в логах веб-сервера — строки с кодом 503, а через несколько дней владелец замечает, что новые страницы не появляются в выдаче, а часть старых пропала. Причина обычно не в наказании, а в механике обхода: поисковый робот не может забрать контент, и это напрямую сказывается на индексации.
Разберём, что именно делает робот при получении серверной ошибки, почему 5xx — не то же самое, что 404, как измерять потери и как настроить ответ сервера так, чтобы плановая недоступность не вредила индексу.
Робот повторяет попытку — но не бесконечно
Получив ответ из группы 5xx, поисковый робот не считает страницу удалённой. Он трактует это как временную неполадку сервера и возвращается позже. В рамках одного сеанса обхода выполняются несколько повторных попыток с небольшими паузами; если успеха нет — URL переносится на следующий визит.
Важно: адрес при этом не вычёркивается из очереди обхода, а откладывается. Но за время, пока запросы падают, робот не обходит новые и обновлённые страницы — и именно здесь начинаются реальные потери.
Почему 5xx — это не 404 и не 403
Ответы различаются по смыслу, и поисковые системы обрабатывают их по-разному:
- 404 Not Found — страницы нет. Робот со временем исключит URL из индекса, но это само по себе не отразится на остальных страницах сайта.
- 403 Forbidden — доступ запрещён. При устойчивом ответе страницы перестают обновляться, а затем исключаются; часто это результат ошибки в настройках сервера или файрвола, а не осознанное решение.
- 5xx Server Error — страница, скорее всего, есть, но сервер не может её отдать. Наиболее «нейтральный» для индекса код: он не сообщает об удалении, а просит вернуться позже.
- Таймаут соединения — ответа нет вообще. Робот не знает, жив ли хост, — это хуже, чем явная 503.
Отсюда простой вывод: если сайт недоступен, всегда лучше отвечать кодом, а не молчать или отдавать зависшее соединение.
Что происходит с индексом: три этапа деградации
Этап 1. Обход замедляется
Первая реакция — снижение частоты обхода хоста. Робот перестаёт тратить бюджет на URL, которые снова вернут ошибку. Если сбой короткий, после восстановления частота возвращается к прежней в течение нескольких дней.
Этап 2. Страницы, которые робот не может подтвердить, стареют
Индексация — процесс подтверждения. Пока робот не может забрать страницу, её версия в индексе остаётся неизменной. Это не критично, если контент не менялся, но плохо для страниц, которые обновляются постоянно: они теряют свежесть, а для части запросов свежесть — существенный фактор.
Этап 3. Устойчивые ошибки ведут к исключению URL
Если 5xx отдаётся долго и по всем адресам, страницы начинают выпадать из индекса. Фиксированного срока «N часов и всё» не существует: решение алгоритмическое и зависит от истории хоста, важности URL и частоты прежнего обхода. Но закономерность надёжна — чем длиннее сбой, тем больше URL затрагивает.

Краулинговый бюджет: куда уходят визиты робота
Краулинговый бюджет — это не «квота страниц в день», а совокупность ограничений: сколько запросов хост может выдержать без вреда для себя, насколько сайт популярен и как много URL подлежит обходу. Понятие становится важным на сайтах с большим числом страниц.
Когда хост отдаёт 5xx, каждый визит робота превращается в потерянный: вместо обхода новых URL он тратит попытку на запрос, который снова вернёт ошибку. Это выглядит как парадокс — «робот приходит, но ничего не индексирует», — хотя фактически робот именно перерасходует бюджет на пустые попытки.
| Симптом | Вероятная причина | Решение |
|---|---|---|
| Обход стал реже после серии сбоев | Робот снизил частоту обхода хоста | Стабилизировать ответы 200, следить, что 5xx не повторяются |
| Новые страницы не появляются в индексе неделями | Робот не доходит до них из-за ошибок на других разделах | Устранить источник 5xx, отправить sitemap, точечно запросить переобход |
| Страницы в индексе не обновляются после правок | Ответы 5xx или заглушки с кодом 200 | Проверить код ответа для каждого шаблона страниц |
| Робот обходит одни и те же URL с ошибкой снова и снова | Постоянно падающий раздел или битые внутренние ссылки | Починить раздел, убрать ссылки на битые шаблоны |
| Резкое падение числа обходов за сутки | Хост недоступен или отвечает ошибками для всех агентов | Проверить доступность снаружи, разобрать логи за сутки |
| Ошибка 5xx только для Googlebot, у вас в браузере всё открыто | CDN, WAF или антибот-фильтр блокирует агента | Проверить правила фильтрации, вернуть код ответа для робота |
Последняя строка — распространённая и коварная причина. Владельцы включают жёсткую защиту от ботов, и она отдаёт роботам 403 или 5xx, а обычным посетителям — штатные страницы. Снаружи сайт выглядит здоровым, а индексация при этом стоит.
Как убедиться, что 5xx видит именно робот
Прежде чем что-то менять, соберите факты. Три проверки дают полную картину.
1. Ответ сервера с агентом робота
Запрос от вашего браузера и запрос от поискового робота — разные запросы. Проверьте оба:
curl -sS -o /dev/null -D - \
  -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" \
  https://example.com/pod-klyuchevoy-stranice
Построчно по флагам:
-sS— без лишнего вывода, но с сообщениями об ошибках (таймаут вы увидите).-o /dev/null— тело ответа отбрасываем, интересуют заголовки и код.-D -— заголовки ответа выводятся на экран.-A "..."— тот же User-Agent, с которым приходит робот. Именно этот параметр показывает, отличается ли ответ для него.- Последний аргумент — конкретный URL. Прогоняйте не только главную, но и страницы разных типов: карточку товара, статью, категорию.
Ожидаемый «здоровый» вывод:
HTTP/1.1 200 OK
Server: nginx
Cache-Control: max-age=600
Content-Type: text/html; charset=utf-8
HTTP/1.1 200 OK— робот получит контент, всё в порядке.Server: nginx— кто отвечает напрямую. Если вы ожидаете CDN, а видите другой сервер, возможен обход промежуточного слоя.Cache-Control: max-age=600— как ответ будет кешироваться. Учтите: если сбой попал в кеш, посетители и роботы могут получать ошибку ещё какое-то время после восстановления.Content-Type— тип содержимого; для HTML-страницы ожидаемtext/html.
Если ответ приходит с кодом 5xx только для агента робота — причина почти всегда в промежуточном слое: CDN, WAF, антибот-фильтр, балансировщик.
2. Ошибки робота в логах веб-сервера
grep -i "Googlebot" /var/log/nginx/access.log \
  | grep -E '" 5[0-9]{2} ' \
  | awk '{print $4, $9}' | cut -c1-15 | sort | uniq -c
grep -i "Googlebot"— только запросы этого агента, регистр не важен.grep -E '" 5[0-9]{2} '— только ответы с кодом 500–599.awk '{print $4, $9}'— дата-время и код ответа.cut -c1-15— оставляем только дату и час, чтобы агрегировать по часам.sort | uniq -c— считаем, сколько ошибок пришлось на каждый час.
Результат:
     12 15/Sep/2026:09
    418 15/Sep/2026:10
    376 15/Sep/2026:11
      3 15/Sep/2026:12
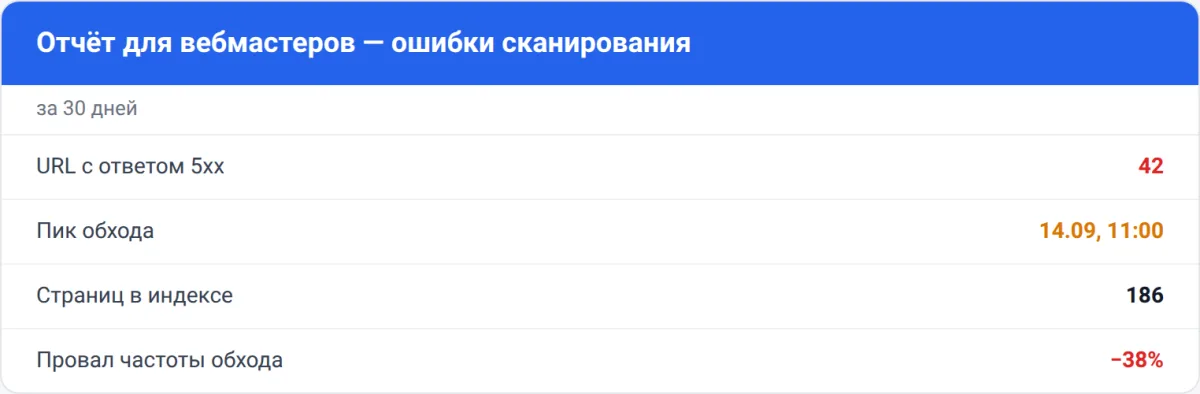
Это и есть окно инцидента: ошибки начались в 09:xx, основная масса пришлась на 10–11, к 12 всё восстановилось. Длительность сбоя здесь — около трёх часов, и именно это число нужно сопоставлять с графиком частоты обхода в панели для вебмастеров.
3. Проверка, что в логах действительно Googlebot
Агента легко подделать: любой скрипт может подставить в User-Agent строку с «Googlebot». Подлинность проверяется обратным DNS-запросом — адрес из логов должен резолвиться в домен поисковой системы, а прямой запрос этого домена — вести обратно на тот же IP.
dig -x 66.249.66.1 +short
dig -x 66.249.66.1— обратный запрос: какой домен соответствует этому IP.+short— краткий вывод, только значение.- Ожидаемый результат вида
crawl-66-249-66-1.googlebot.com— признак подлинности. Если в ответ приходит произвольный домен или ничего, запросы, вероятно, шлёт сторонний бот.
Обратная проверка (имя → адрес) делается так:
dig +short crawl-66-249-66-1.googlebot.com
Полученный адрес должен совпасть с исходным. Это базовое правило: не блокируйте агента по одной строке User-Agent, не проверив его происхождение, иначе рискуете закрыть доступ настоящему роботу и открыть подделывающемуся.
Как правильно отвечать при плановых работах
Если сайт недоступен осознанно — обновление, миграция, отключение базы — правильный ответ сервера экономит вам недели восстановления индексации.
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
Content-Type: text/html; charset=UTF-8
Cache-Control: no-store
Разбор:
503 Service Unavailable— явный сигнал «временно, страница существует». Это ключевой код для плановой недоступности: он не сообщает об удалении URL.Retry-After: 3600— сколько секунд подождать до возвращения. Заголовок превращает сбой из тревожного сигнала в понятное роботу указание. Если работы закончатся раньше — не страшно, робот просто придёт позже.Cache-Control: no-store— запрет сохранять ответ. Это важно: закешированная ошибка может выдаваться посетителям и роботам ещё долго после того, как сайт заработал.Content-Type— корректный тип, чтобы браузер показал человеку внятную страницу о работах.
| Ситуация | Правильный код | Почему именно он |
|---|---|---|
| Плановые работы, сайт вернётся через час | 503 + Retry-After |
Сигнал «временно», URL сохраняется в индексе |
| Аварийный сбой, длительность неизвестна | 503 с оценкой срока |
Не сообщает об удалении страницы, даёт роботу ориентир по времени |
| Отдельный раздел отключён надолго | 503 на этом разделе |
Проблема локализована, остальной сайт обходится штатно |
| Постоянная ошибка в приложении | Устранить причину, не маскировать кодом | Обход не возобновится, пока сервер не начнёт отдавать контент |
| Нужно срочно скрыть контент | 503, а не Disallow |
Запрет в robots.txt не убирает уже проиндексированные страницы |
Чего делать не стоит:
- Отдавать 200 со статической заглушкой. Для поисковой системы это выглядит как замена содержимого всех страниц одинаковым текстом. Последствия могут быть тяжелее, чем честная 503.
- Закрывать сайт через
Disallow: /в robots.txt. Это не тот инструмент: запрет в robots.txt управляет обходом, а не индексацией, и не мешает уже проиндексированным страницам оставаться в выдаче. Для срочной скрытности используют код 503. - Пропускать запросы робота через файрвол. Блокировка по IP или User-Agent даёт ответ 403 или обрыв соединения — ровно те сигналы, которых нужно избегать.
- Ставить бесконечный редирект на страницу работ. Если цепочка редиректов превышает разумную длину, робот прекращает попытки и фиксирует ошибку.
Дополнительно про саму ошибку 500 — когда она не временная, а следствие сбоя в приложении — разобрано в статье «Ошибка 500 Internal Server Error: причины и как найти».
Чек-лист после инцидента с 5xx
- Зафиксировать окно сбоя — начало, конец, коды ответов. Именно эта длительность, а не ощущение «долго лежало», определяет последствия.
- Убедиться, что робот снова получает 200 — отдельно проверить ответ с агентом робота инструментом проверки доступности на 3–5 ключевых URL разных типов.
- Проверить отсутствие закешированных ошибок — если ответ отдавался через CDN, очистить кеш для пострадавших страниц.
- Проверить robots.txt — файл должен быть доступен и не содержать запрета на весь сайт.
- Убедиться, что sitemap актуален — отдать актуальную версию, чтобы ускорить повторный обход.
- Точечно запросить переобход самых важных страниц в панели для вебмастеров.
- Вернуть правила защиты в исходное состояние — если на время сбоя антибот-фильтр был ужесточён, ослабьте его обратно, иначе потери обхода продолжатся без видимой причины.
- Следить за восстановлением 2–4 недели — частота обхода и объём проиндексированных страниц возвращаются не сразу.
Полезно также свериться с общей картиной влияния простоя на выдачу и позиции — она разобрана в статье «Влияет ли падение сайта на SEO»: там про то, как длительность сбоя соотносится с риском для индекса и через какие механизмы недоступность отражается на трафике.
Как не допускать длинных окон с ошибками
Практика показывает: ущерб от 5xx определяется не кодом ответа, а длительностью, за которую вы о них не знали. Три вещи снижают это время до минимума.
- Внешняя проверка по расписанию. Внутренние системы вроде Zabbix следят за здоровьем сервера изнутри — нагрузкой, памятью, дисками, работой служб. Но они не заметят, что сайт не отвечает внешнему миру: упал маршрут, сломались правила на балансировщике, истёк сертификат. Внешняя проверка доступности отвечает на другой вопрос — видит ли сайт посетитель и получит ли робот код 200. Эти два подхода дополняют друг друга, а не заменяют.
- Проверка ключевых URL, а не только главной. Основные разделы и шаблоны страниц часто обслуживаются разными бэкендами. Главная может отдавать 200, пока каталог лежит с ошибкой, и наоборот.
- Контроль смежных зон. Истёкший SSL-сертификат или просроченный домен для робота — та же недоступность, что и 5xx, только с более резким сигналом. Проверять их стоит заранее, а не когда браузер начнёт предупреждать посетителей.
Наконец, стоит помнить о пропорциях. Краулинговый бюджет — ограничитель в первую очередь для крупных сайтов с сотнями тысяч URL. Небольшому сайту из нескольких десятков страниц серия 5xx навредит не через бюджет, а через задержку обновления индекса и потерю свежести, если сбой пришёлся на момент публикации важного контента.
Коротко
Googlebot, получая 5xx, не считает страницу удалённой: он делает несколько повторных попыток, откладывает визит и возвращается позже. Основные потери — замедление обхода, устаревание версий страниц в индексе и, при длительных сбоях, исключение URL. Краулинговый бюджет тратится на неудачные запросы, поэтому окно ошибок важно закрывать быстро.
Для плановой недоступности правильный ответ — 503 с заголовком Retry-After и запретом кеширования; хуже всего отдавать 200 с заглушкой или закрывать сайт через robots.txt. Диагностика начинается с проверки ответа сервера для агента робота и подсчёта ошибок 5xx в логах веб-сервера с проверкой подлинности агента обратным DNS-запросом.
Держать окно ошибок коротким помогает внешняя проверка ключевых страниц — например, в UptimeChecker: код ответа для каждой проверки виден сразу, и о 5xx становится известно в начале инцидента, а не по падению трафика через неделю.


