Влияет ли падение сайта на SEO
Почему у вопроса «влияет ли падение сайта на SEO» нет короткого ответа
«Сайт лежал полчаса — позиции просядут?» Однозначного «да» или «нет» здесь нет, и любой, кто отвечает иначе, либо упрощает, либо продаёт панику. Итог зависит от четырёх переменных: как долго сайт был недоступен, что именно возвращал сервер в ответ на запросы поисковых роботов, насколько важны пострадавшие страницы и как часто они обходились до сбоя.
Пятнадцатиминутная недоступность при перезапуске сервиса в три часа ночи, скорее всего, не оставит следов вообще: робот просто не попал в это окно. Неделя лежащего сервера с ошибкой на всех страницах — это другой сценарий, и последствия будут видны и в индексе, и в трафике, и в поведенческих метриках, а восстановление займёт недели.
Эта статья — про то, как поисковые системы в действительности обрабатывают недоступность, какие есть подтверждённые механизмы влияния (а какие последствия приписывают простою зря), как самостоятельно зафиксировать и оценить ущерб командами curl и разбором логов, и что делать сразу после восстановления.
Что видит поисковый робот, когда сайт перестал отвечать
Поисковый робот не знает, что «сайт упал». Он видит ответ на конкретный HTTP-запрос и делает вывод. Именно код ответа, а не сам факт недоступности, определяет, что произойдёт с URL.
Ключевое различие: молчащий сервер и сервер с ошибкой
Если соединение вообще не устанавливается — DNS не отдаёт адрес, порт закрыт, TCP-сессия обрывается по таймауту — робот не получает никакой информации о содержимом. Такой сбой неотличим от сетевой аварии на стороне сети и трактуется как временная проблема на нашей стороне или на стороне инфраструктуры.
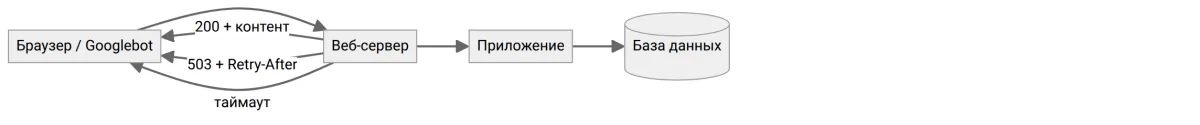
Другая ситуация — сервер отвечает, но с кодом из группы 5xx. Здесь робот точно знает: сервер жив, страница, скорее всего, существует, но отдать её сейчас невозможно. Это важное отличие, потому что означает временный характер проблемы — и именно так оно и обрабатывается.
Таблица: код ответа → трактовка роботом → последствие для индекса
| Что возвращает сервер | Как это понимает поисковый робот | Что происходит с URL |
|---|---|---|
200 OK со нормальным HTML |
Всё в порядке | Страница обходится и обновляется в индексе |
503 Service Unavailable с заголовком Retry-After |
Плановое обслуживание, сервер работает штатно | Страница сохраняется, робот возвращается после указанного срока |
503 без Retry-After |
Временная недоступность | Страница сохраняется, но проверки учащаются, обход замедляется |
500, 502, 504 на всех страницах |
Сбой на стороне сервера | Страница остаётся в индексе, но переобход откладывается, доверие к хосту снижается |
403 Forbidden для робота при работающем сайте |
Доступ запрещён | Страницы перестают обновляться, при устойчивости — выпадают |
Пустой ответ, Connection refused, таймаут |
Сайт недоступен, причина неясна | Поведение как при 5xx, но без явного сигнала о плановости |
| DNS-запись отсутствует (NXDOMAIN) | Домена по этому имени нет | Самый опасный вариант: робот может счесть, что хост исчез |
200 OK, но с текстом «сайт на обслуживании» |
Ложный успех | Робот индексирует заглушку вместо содержимого — то есть затирает реальные страницы |
Последняя строка — недооценённая ловушка. Когда при падении бэкенда веб-сервер отдаёт статическую заглушку с кодом 200, для поисковой системы это выглядит как полная замена контента всех страниц на один и тот же текст. С точки зрения SEO это может быть хуже, чем честная 503.
Три механизма, через которые недоступность влияет на позиции
Полезно разделить фактическое влияние (то, что подтверждается документацией поисковых систем и наблюдаемыми данными) и косвенное (то, что влияет на ранжирование опосредованно). Смешивать их — верный способ неверно оценить риск.
Механизм 1. Замедление обхода и перерасход краулингового бюджета
Пока хост отдаёт ошибки, робот не получает того, за чем пришёл. Каждая неудачная попытка — это потраченный впустую визит: вместо обхода новых и обновлённых страниц бюджет обхода тратится на запросы, которые снова вернут ошибку. Механика этого процесса, способы измерить перерасход и правильные настройки подробно разобраны в отдельной статье про Googlebot и 5xx.
Практический вывод: свежий контент, новые страницы и изменения на существующих URL попадут в индекс позже, чем могли бы. На крупных сайтах с миллионами URL это заметно; на небольшом корпоративном сайте эффект слабее, но он есть.
Механизм 2. Временное выпадение URL из индекса
Документация поисковых систем не описывает фиксированного порога вроде «48 часов недоступности — и страница выброшена». Решения принимаются алгоритмически и учитывают историю хоста, важность страницы, частоту обхода и характер сбоя. Но практика устойчива: чем дольше длится сбой и чем реже страница обходилась до него, тем выше шанс временного исключения.
Отдельно стоит сказать про распространённый миф: перерыв в доступности сам по себе не наказывается «понижением» сайта. Страницы не получают штраф за то, что сервер лежал. Речь идёт именно об устаревании индекса и временном исключении тех URL, контент которых нельзя подтвердить.
Механизм 3. Отложенная просадка после восстановления
Обратная сторона медали: после того как сайт вернулся, позиции не восстанавливаются мгновенно. Робот должен заново обойти страницы, убедиться, что они доступны, обновить версии в индексе, а системе ранжирования — накопить свежие сигналы о качестве. Этот хвост обычно длиннее, чем сам простой: часы недоступности могут дать дни восстановления, а сутки — недели.
Механизм 4. Косвенные потери, которых нет в отчётах
Их часто упускают, хотя они бывают дороже всего:
- Поведенческие сигналы. Посетители, попавшие на ошибку, уходят. Доля отказов растёт, глубина просмотра падает, повторных визитов становится меньше.
- Упущенная внешняя ссылность. Пока сайт лежит, авторы и партнёры не ставят ссылки: страница не открылась, ссылку не добавили. Вы не увидите это ни в одном отчёте, но это потерянные позиции в будущем.
- Потеря конверсий и денег. Это не про SEO напрямую, но именно эти потери делают простой проблемой бизнеса, а не только технической.
- Репутация домена у пользователей. Люди возвращаются на сайт, который в прошлый раз открылся. Если не открылся — часть аудитории вы не вернёте, даже когда всё почините.
Сколько простоя допустимо: ориентиры по длительности
Единого норматива нет, но есть рабочая шкала, которую удобно использовать для приоритизации реакции.
| Длительность недоступности | Типичный риск для SEO | Что делать |
|---|---|---|
| До 1–5 минут | Практически нулевой | Разобрать причину, если повторяется — это признак нестабильности |
| 5–30 минут | Минимальный | Зафиксировать в журнале, проверить логи на ошибки 5xx в момент сбоя |
| 30 минут — 3 часа | Временное замедление обхода, возможна задержка индексации нового | После восстановления проверить коды ответа и запросить переобход ключевых страниц |
| 3–24 часа | Заметная задержка переобхода, часть страниц может выпасть из индекса | Проверить, что робот снова получает 200, разобрать ошибки сервера, следить за трафиком 2–4 недели |
| более 24 часов | Устойчивое исключение части URL, потеря позиций и трафика | Пост-инцидентный чек-лист, переобход, контроль восстановления индекса |
| более недели с ошибкой 5xx на всех страницах | Глубокая просадка, потеря свежести всего домена | Восстановление как проект: техническое + контентное + ссылочное |
Пороги здесь — ориентир для приоритизации, а не гарантия. Сайт-визитка и новостной портал с тысячами ежедневных публикаций при одинаковых 6 часах простоя потеряют совершенно по-разному: у второго остановится поток свежего контента, который и есть основа его выдачи.
Как зафиксировать, что именно произошло: команды и логи
Первый шаг разбора — превратить «сайт лежал» в факты: какой код отдавал сервер, что видел поисковый робот, какова была доля недоступности.
Проверка кода ответа так, как его увидит робот
Ключевой момент: смотреть нужно не браузером, а внешним клиентом и с тем же User-Agent, с каким приходит поисковый робот. Некоторые CDN и WAF настроены так, что отдают 5xx только незнакомым агентам — при этом у вас в браузере всё открывается.
curl -sS -o /dev/null -D - \
  -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" \
  https://example.com/
Разберём флаги:
-sS— тихий режим, но с выводом ошибок: обычный-sподавил бы и сообщения о таймаутах, которые здесь важны.-o /dev/null— тело ответа отбрасываем, нам нужны заголовки и код.-D -— вывести заголовки ответа в стандартный поток (на экран).-A "..."— подставить User-Agent поискового робота, чтобы увидеть ответ, предназначенный ему.https://example.com/— проверяемый адрес; для оценки инцидента полезно прогнать главную и 2–3 ключевые страницы.
Возможный вывод:
HTTP/1.1 503 Service Unavailable
Date: Mon, 15 Sep 2026 09:12:04 GMT
Retry-After: 3600
Cache-Control: no-cache
Content-Type: text/html; charset=UTF-8
HTTP/1.1 503 Service Unavailable— код и причина. 503 означает «временно, скоро вернёмся», это «правильная» ошибка для плановых работ.Retry-After: 3600— сервер прямо говорит, через сколько секунд возвращаться. Здесь — через час. Наличие этого заголовка — самый чистый сигнал роботу, что сбой плановый.Cache-Control: no-cache— просьба не кешировать ответ. Полезно, чтобы промежуточные прокси не запомнили ошибку.Content-Type— тип тела. Если сервер отдаёт 503 с HTML-текстом о работах, для человека это читаемо, для робота — просто 503.
Если вместо заголовков вы видите:
curl: (28) Failed to connect to example.com port 443 after 10000 ms: Timeout was reached
— код (28) означает таймаут. Соединение не установилось вовсе. Для SEO это «молчащая» недоступность: робот не получил ни кода, ни содержимого, а значит, не может отличить ваш сбой от сетевой аварии.
Проверка, видел ли ваши 5xx поисковый робот
Ошибки в логах веб-сервера — прямое доказательство. Команда группирует ответы 5xx, отданные запросам с агентом Googlebot, по коду:
grep -i "Googlebot" /var/log/nginx/access.log \
  | grep -E '" 5[0-9]{2} ' \
  | awk '{print $9}' | sort | uniq -c | sort -rn
grep -i "Googlebot"— оставляем только запросы с этим агентом в строке (флаг-iигнорирует регистр).grep -E '" 5[0-9]{2} '— фильтруем по коду ответа в диапазоне 500–599. Кавычка перед пробелом нужна, чтобы не поймать случайные совпадения в других полях.awk '{print $9}'— в типовом формате nginx девятое поле и есть код ответа.sort | uniq -c | sort -rn— считаем, сколько раз встречается каждый код, и сортируем по частоте.
Вывод вида:
   4821 503
    612 500
     17 502
означает: робот за период получил 4821 ответ 503, 612 — 500 и 17 — 502. Точка отсчёта для оценки ущерба: чем больше таких строк и чем дольше они идут подряд, тем серьёзнее последствия.
Полезно также посмотреть по времени, когда робот приходил и что получал:
awk '$9 ~ /^5/ && tolower($0) ~ /googlebot/ {print $4, $9}' /var/log/nginx/access.log | sort | uniq -c
$9 ~ /^5/— условие: код ответа начинается с5.tolower($0) ~ /googlebot/— агент в строке, приведённой к нижнему регистру, содержит googlebot.{print $4, $9}— выводим дату-время и код;uniq -cпокажет число попаданий по секундам.
Так становится видно окно сбоя — например, что все 503 пришлись на интервал 09:00–11:30.
Оценка доли недоступности
Если нужно быстро посчитать, какую часть времени сайт отдавал ошибку, есть смысл начать с ручного мини-опроса. Это не замена постоянному мониторингу, но позволяет понять масштаб прямо сейчас:
for i in $(seq 1 30); do
  code=$(curl -s -o /dev/null -w "%{http_code}" -m 10 https://example.com/)
  echo "$(date -Is) $code"
  sleep 20
done
for i in $(seq 1 30)— 30 итераций.-w "%{http_code}"— вывести только код ответа.-m 10— таймаут 10 секунд на попытку (иначе зависший сервер подвесит всю команду).sleep 20— пауза между проверками. Итого около 10 минут наблюдения.
Дальше долю ошибок и время недоступности удобнее считать не вручную, а в калькуляторе доступности: он переводит минуты и часы простоя в проценты аптайма и наоборот. Цифра вроде «99,9%» звучит абстрактно, пока не увидите, что это почти 44 минуты недоступности в месяц — и весь этот бюджет уже израсходован одним утренним сбоем.
Как понять, что проблема была не на стороне сервера
Половина «падений» — локальные. Сайт не открывался у вас из офиса, потому что упал корпоративный DNS, а для остального мира всё работало штатно; или страница отдавала ошибку только для авторизованных пользователей. Если разбираться достоверно, полезно проверить сайт с внешней точки — это исключает ваш браузер, кеш, DNS и провайдера.
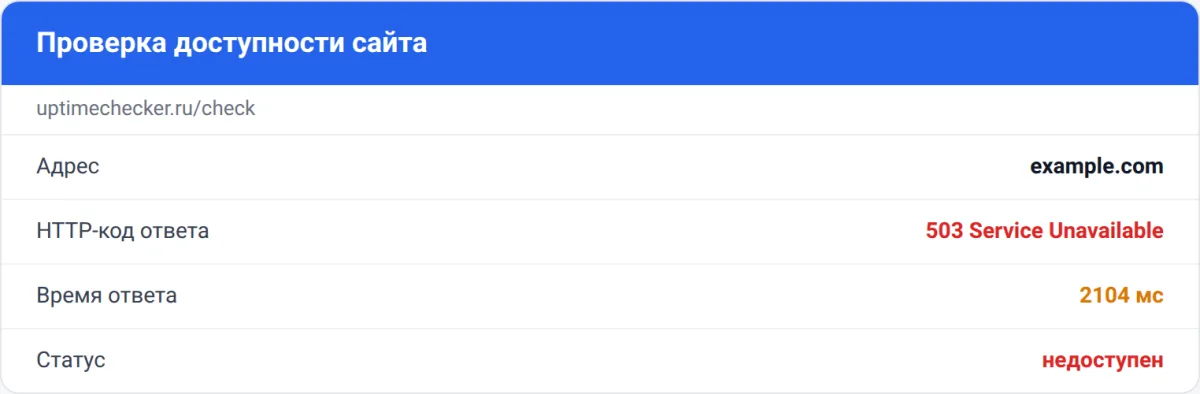
Проверка доступности внешним инструментом — uptimechecker.ru/check — показывает, какой код отвечает сервер для внешнего наблюдателя. Она же поможет отличить «сайт реально лежал» от «у меня не открывалось».
Если точнее нужно понять, что видит посетитель (ошибка соединения, заглушка хостинга, редирект в никуда), разбор типичных сценариев есть в статье «Сайт не открывается: пошаговая диагностика».
Важный частный случай — «мягкая» недоступность, когда сервер отдаёт 200, но посетитель видит заглушку или пустую страницу. С точки зрения SEO такой сбой может быть опаснее явной 503, потому что поисковая система считает контент обновлённым.
Что делать после восстановления
Алгоритм, который имеет смысл пройти один раз после каждого заметного простоя.
- Убедиться, что код ответа вернулся к 200 — для всех типов посетителей. Не только для вашего браузера, но и для агента поискового робота, и с разных страниц, а не только с главной. Отдельно проверьте, что нет оставшихся 5xx на разделах, которые обслуживаются другим бэкендом.
- Проверить, что отдаётся реальный контент. Быстрая проверка: сравнить размер ответа и заголовок
Content-Type. Заглушка «сервер перегружен» часто весит 1–2 КБ и отдаётся с кодом 200. - Проверить robots.txt. Частая ошибка при аварии — закрыть сайт от роботов строкой
Disallow: /, чтобы «не портить индексацию ошибками». Это делает хуже: робот сбрасывает уже собранные данные. Убедитесь, что файл доступен и не содержит запрета на весь сайт. - Разобрать причину. Логи, время сбоя, изменения в конфигурации и деплое за последние сутки. Простой без понятой причины обязательно повторится.
- Ускорить переобход ключевых страниц. Отправить актуальный sitemap и запросить переобход основных URL в панели для вебмастеров — это не гарантия, но ускоряет возврат свежести.
- Следить за трафиком 2–4 недели. Просадка после восстановления часто приходит с задержкой. Если через две недели трафик по ключевым страницам не вернулся к уровню до сбоя — есть смысл посмотреть, не выпали ли они из индекса, и заняться содержательным обновлением контента.
- Не менять контент в панике. Переписывание или массовое удаление страниц сразу после простоя — плохая идея: оно смешивает два разных сигнала и мешает понять, что именно влияет на позиции.
Как снизить риск простоя заранее
Основной инструмент здесь — не реакция, а обнаружение. Чем раньше вы узнаете о падении, тем короче окно недоступности, которое увидит поисковый робот.
- Внешняя проверка по расписанию. Мониторинг извне сети — единственный способ узнать о падении, когда сам сервер об этом сообщить не может. Проверять стоит не только главную, но и ключевые разделы: страница каталога и главная часто обслуживаются по-разному.
- Проверка с несколькими кодами ответа. Не только «открывается/не открывается», но и контроль, что сервер возвращает именно 200, а не 503 под нагрузкой.
- Контроль смежных зон. SSL-сертификат и срок домена — источники внезапной недоступности, которые не связаны с сервером, но дают ровно те же последствия для SEO.
- Свой журнал инцидентов. Дата, длительность, код ответа, что чинили. Через полгода это единственный способ понять, что у сайта системная проблема, а не случайность.
Внутренние системы мониторинга инфраструктуры вроде Zabbix решают другую задачу: они смотрят на состояние сервера изнутри — нагрузку, память, диски, работу служб. Это полезно для понимания причин, но не отвечает на вопрос, виден ли сайт посетителю и поисковому роботу из интернета. Внешняя проверка доступности и внутренний мониторинг инфраструктуры дополняют друг друга: один сигнализирует о причине, второй — о последствиях, уже заметных пользователям.
Коротко
Падение сайта влияет на SEO не самим фактом, а тем, что видит поисковый робот в момент сбоя. Ответ 503 с заголовком Retry-After — это корректный сигнал о плановой недоступности; ответ 500–504 на всех страницах и молчащие таймауты замедляют обход и откладывают обновление индекса; заглушка с кодом 200 способна затереть содержимое страниц в индексе. Решающие факторы — длительность сбоя, важность пострадавших URL и то, как регулярно они обходились до него.
Проверить фактическое состояние сайта внешним взглядом можно в инструменте проверки доступности, а оценить допустимую длительность простоя и долю недоступности в процентах — в калькуляторе аптайма. Регулярная внешняя проверка ключевых страниц даёт то, чего не даёт разбор логов после факта: понимание, что простой начался, пока он ещё длится.


