Мониторинг сайтов клиентов для агентства
Зачем агентству мониторинг клиентских сайтов
Агентство отвечает за десятки проектов одновременно. Сайт клиента может лечь в любой момент: упал сервер, истёк SSL-сертификат, сменилась DNS-запись, редирект замкнулся в петлю. Если проблему первым заметил клиент, а не вы — потерян не один проект, а доверие по всему портфелю: клиенты редко оценивают агентство отдельно по каждому сайту, они экстраполируют один инцидент на все.
Мониторинг сайтов клиентов закрывает три задачи разом:
- Заметить проблему раньше клиента. Алерт приходит на email в момент падения, а не через день в виде претензии в мессенджере.
- Локализовать причину быстрее. Проверка доступности, SSL, DNS и портов по отдельности сразу показывает, где именно сломалось.
- Показать работу в цифрах. Аптайм, скорость реакции, история инцидентов — это материал для отчёта, который клиент понимает и ценит.
Ключевой сдвиг в мышлении такой: мониторинг — это не «ещё одна утилита для поддержки», а часть клиентского сервиса. Агентство, которое присылает отчёт об аптайме и реагирует на падение до того, как о нём спросили, воспринимается как надёжный подрядчик, а не как исполнитель, который «делает сайт и забывает о нём».
Это в равной мере касается и классических digital-студий, и агентств, которые строят продукты на базе AI: для них доступность сайта или приложения — такое же базовое требование клиента, а значит, мониторинг встраивается в тот же операционный контур. Подробнее о специфике для этой категории — в отдельном материале про мониторинг для AI-агентств.
Что мониторить: минимальный набор проверок
«Сайт работает» — слишком общая формулировка, чтобы из неё строить процесс. Полезно разложить доступность на проверяемые составляющие. Для типового клиентского проекта достаточен такой набор:
| Что проверяем | Что ловим | Чем проверяем |
|---|---|---|
| Доступность по HTTP/HTTPS | Сайт отдаёт ошибку или не отвечает | Проверка доступности |
| Код ответа и контент | 500 вместо 200, «белый экран», заглушка хостинга | Проверка доступности |
| SSL-сертификат | Сертификат истёк или вот-вот истечёт | Проверка SSL |
| DNS-записи | A/AAAA, CNAME, MX изменились или не резолвятся | Проверка DNS |
| Домен | Истёк срок регистрации, домен заблокирован | Проверка домена |
| Порт | 443 или 80 закрыты, сервис недоступен | Проверка порта |
| Скорость/TTFB | Сайт отвечает, но медленно | Проверка скорости |
| Редиректы | Петля редиректов, разрыв цепочки | Проверка редиректов |
Зачем разбивать так подробно? Потому что «сайт не открывается» — это симптом, а не диагноз. Разные причины требуют разных действий: истёкший сертификат чинится перевыпуском за пять минут, упавший DNS — правкой записи у регистратора, а медленный ответ — разговором с хостером или оптимизацией. Чем точнее вы знаете, что именно сломалось, тем быстрее реагируете.
Что чаще всего падает на практике
По опыту агентств, основная масса инцидентов — не «упал весь сервер», а тихие, малозаметные вещи:
- Просроченный SSL-сертификат. Самая частая и самая обидная причина. Сертификат истекает ровно в срок, а человек о нём забывает — автоматическое продление Let's Encrypt настраивают не всегда, а платные сертификаты часто продлеваются вручную.
- Смена DNS у регистратора. Клиент «почистил» записи, сменил хостера, перенёс домен — и сайт стал резолвиться в пустоту или на старый сервер.
- Петля редиректов после переезда с http на https или смены домена: цепочка
http → https → httpзамыкается, браузер сдаётся после N переходов. - Заглушка хостинга или «парковочная» страница — хостинг отключил сайт за неоплату или превышение лимитов, а контент подменил своей заглушкой, которая при этом отдаёт код 200.
Ключевой вывод: мониторинг, который проверяет только «отвечает ли сервер кодом 200», пропустит три из четырёх этих сценариев. Заглушка хостинга — это 200. Петля редиректов на промежуточном этапе может тоже отдать 200. Поэтому нужны проверки именно по слоям: доступность, SSL, DNS, контент.
Единая панель вместо «зоопарка» инструментов
Когда у агентства 5 клиентов, можно держать всё в закладках и проверять руками. Когда 50 — ручная проверка перестаёт работать: вы просто физически не успеваете открыть 50 сайтов, посмотреть сертификаты и проверить DNS, а главное — не можете находиться в этом состоянии круглосуточно.
Проблема не в том, что нечем проверить — инструментов много. Проблема в том, что они разрознены: один сервис смотрит аптайм, другой — сертификаты, третий — DNS, и у каждого свой интерфейс, свой алерт и свой формат отчёта. Инженер тратит время на переключение между вкладками, а не на решение проблемы.
Для агентства важна именно единая панель, в которой:
- все сайты портфеля видны одним списком со статусами;
- по каждому сайту в одном месте собраны проверки доступности, SSL, DNS, портов;
- алерты приходят в один канал в едином формате;
- из этой же панели можно вытащить отчёт для клиента.
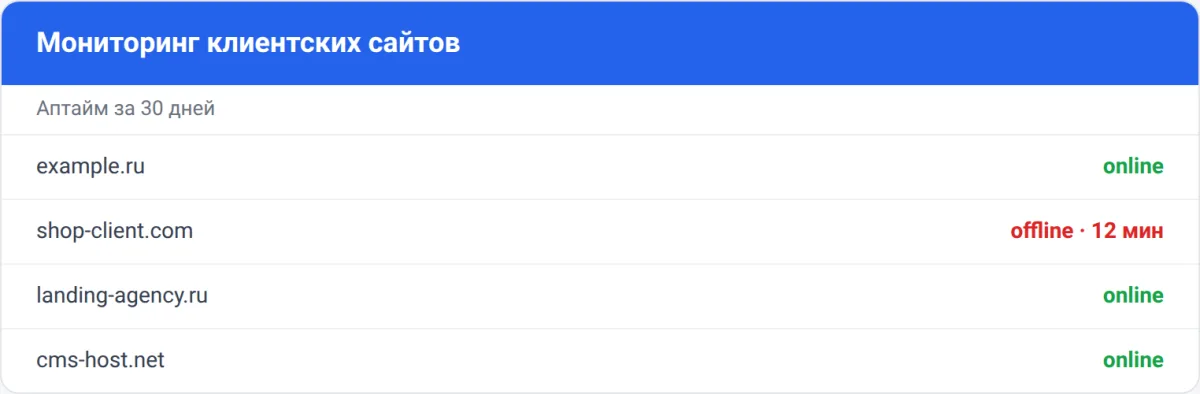
Такой подход экономит не минуты, а часы в неделю. Когда инцидент случается в пятницу вечером, инженер открывает одну панель, видит «сайт клиента X — SSL истекает завтра», и решает вопрос за десять минут вместо часа раскопок по трём сервисам.
Как организовать портфель
Начинайте не с инструмента, а со списка. Заведите реестр клиентских сайтов: домен, на каком хостинге, кто владелец, каким способом продлевается SSL, где лежит доступ к DNS. Этот реестр — источник правды, из которого конфигурируются проверки. Один раз заполнили — дальше мониторинг работает сам и напоминает о событиях, которые человек забыл бы (срок сертификата, срок домена).
Практический совет: привязывайте проверки не к «сайту вообще», а к конкретному URL и конкретному порту. Для каждого клиента заводите как минимум проверку главной страницы и проверку SSL. Для проектов с админкой, API или платёжным шлюзом добавляйте отдельные URL — падение /api не всегда видно по главной странице.
Алерты до простоя, а не после
Разница между «мониторингом» и «мониторингом, который спасает» — в том, когда вы узнаёте о проблеме. Три уровня зрелости:
| Уровень | Что происходит | Результат |
|---|---|---|
| Проверка вручную | Инженер открывает сайты, когда вспомнит | Проблемы находят с опозданием в дни |
| Алерт по факту падения | Пришло письмо, что сайт уже лежит | Реагируете после того, как простой начался |
| Алерт до инцидента | Предупреждение об истекающем сертификате, домене | Чините заранее, простоя не было |
Именно третий уровень — то, что агентство может продавать клиенту как ценность. Истекающий через 14 дней SSL-сертификат — это не «проблема», а «запланированная задача». Если мониторинг предупреждает о таких событиях заранее, агентство перевыпускает сертификат в рабочее время, а не поднимает инженера в три часа ночи, когда клиент пишет «сайт не открывается».
Проверка доступности, которая опрашивает сайт с интервалом и шлёт алерт на подтверждённый email при падении, — базовый уровень. К нему добавляются превентивные проверки: срок действия SSL (проверка срока SSL), срок регистрации домена (проверка домена). Именно сочетание «реагируем на падение» и «предупреждаем о скором падении» закрывает картину.
Настройте пороги осмысленно
Алерт, который срабатывает по любому чиху, быстро превращается в белый шум, который игнорируют. Настройте пороги так, чтобы каждое уведомление требовало действия:
- SSL: предупреждать за 14 дней до истечения, а не за 1 день — тогда есть время на перевыпуск в рабочие часы.
- Домен: предупреждать за 30 дней до истечения регистрации — продление домена иногда занимает время, особенно при смене регистратора.
- Доступность: алертить по факту падения, но с повтором через интервал — один «моргнул» сервер не должен поднимать тревогу, а вот «не отвечает 5 минут подряд» должен.
Отчёты клиенту: из метрик в доверие
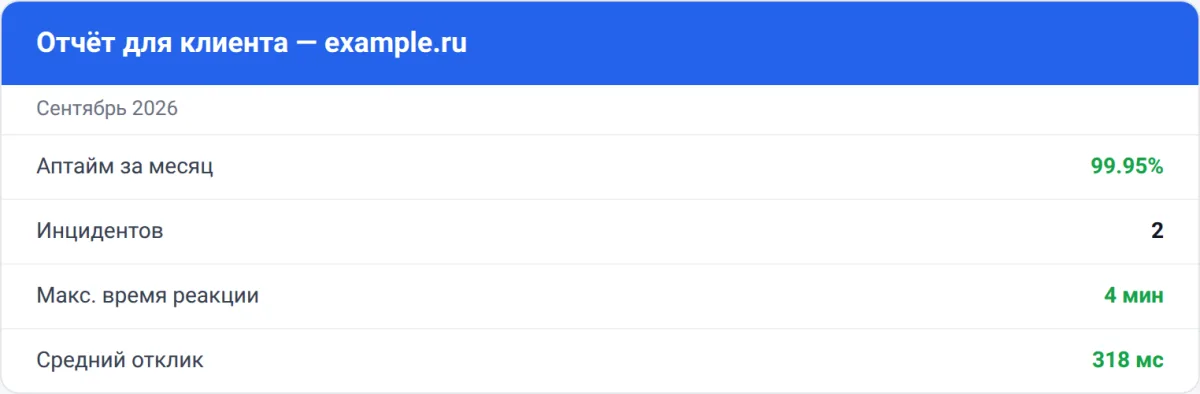
Клиент не обязан понимать, что такое TTFB и как работает DNS. Но клиент отлично понимает две вещи: «сайт работал 99,98% времени» и «вы отреагировали на проблему за 12 минут, пока я об этом даже не узнал». Отчёт — это способ перевести техническую работу в понятную клиенту валюту.
Что обычно входит в отчёт о доступности:
- Аптайм за период (месяц/квартал) в процентах и в часах простоя.
- Список инцидентов: что случилось, когда, сколько длилось, что сделано.
- Превентивные работы: какие сертификаты перевыпущены, какие домены продлены до истечения.
- Скорость ответа как индикатор «сайт не только жив, но и быстр».
Чтобы отчёт не превращался в ручную работу, полезно заранее решить, что именно вы считаете и откуда берёте цифры. Калькулятор доступности помогает переводить «99,9%» в понятные клиенту часы простоя: калькулятор доступности. Для клиента разница между 99% и 99,99% — это разница между «сайт лежал 7 часов в месяц» и «сайт лежал 4 минуты в месяц». Одна цифра, два совершенно разных впечатления.
Регулярность важнее объёма
Короткий ежемесячный отчёт ценнее, чем подробный годовой. Клиент привыкает к ритму: раз в месяц приходит письмо со статусом его проекта. Это формирует ощущение, что агентство «ведёт» проект, даже если в этом месяце ничего не падало. А когда инцидент всё-таки случается, он ложится в уже привычный формат, а не выглядит как «внезапно обнаружили».
SLA: как связать мониторинг с обязательствами
Мониторинг становится сильнее, когда он завязан на SLA — соглашение об уровне сервиса, в котором зафиксированы целевые значения доступности и время реакции. Отдельная статья блога разбирает, как составить SLA-шаблон для агентства и что в него включать: SLA-шаблон для агентства.
Ключевая связка такая: SLA фиксирует обещание, а мониторинг доказывает, что обещание выполняется. Без мониторинга SLA — это слова на бумаге. С мониторингом — это измеримое обязательство: аптайм, время реакции и история инцидентов подтверждаются данными, а не воспоминаниями.
Типичная логика SLA для веб-агентства:
| Параметр | Типичное значение | Чем подтверждается |
|---|---|---|
| Аптайм сайта | 99,9% в месяц | Лог проверок доступности |
| Время реакции на инцидент | 30–60 минут в рабочее время | Время от алерта до первого действия |
| Уведомление о плановых работах | за 48 часов | Журнал плановых работ |
| Срок перевыпуска сертификата | до истечения | Превентивные проверки SSL |
Важно не обещать то, что не можете подтвердить. Если вы фиксируете в SLA аптайм 99,99%, а мониторинга нет — вы обещаете вслепую. Если мониторинг есть, но показывает 99,5% — вы либо чините инфраструктуру, либо пересматриваете цифру. Честность здесь работает на агентство: клиент охотнее доверяет подрядчику, который показывает реальные цифры, чем тому, кто рисует идеальные.
Самопроверка без панели: curl, openssl, dig
Панель мониторинга — это про регулярность и алерты. Но бывает, что нужно проверить что-то прямо сейчас, руками, чтобы понять картину до настройки мониторинга или в момент инцидента. Три команды закрывают 90% таких ситуаций.
Проверка доступности и кода ответа — curl
curl -s -o /dev/null -w "%{http_code} %{time_total}s\n" https://example.com
Разбор вывода построчно:
-s— тихий режим, без прогресс-бара;-o /dev/null— не выводить тело ответа, нам нужен только код;-w "%{http_code} %{time_total}s\n"— вывести HTTP-код и общее время запроса.
Результат вида 200 0.42s означает: сайт отвечает, код 200, время около 0,4 секунды. Код 500 или 502 — сайт «жив», но на сервере ошибка. Пустой вывод или ошибка соединения — сайт не отвечает вовсе.
Полезно добавить проверку редиректов:
curl -s -o /dev/null -w "%{http_code} -> %{redirect_url}\n" https://example.com
Здесь %{redirect_url} покажет, куда сервер отправляет клиента. Если редирект ведёт сам на себя или цепочка не заканчивается — у вас петля.
Проверка SSL-сертификата — openssl
echo | openssl s_client -connect example.com:443 -servername example.com 2>/dev/null | openssl x509 -noout -dates
Разбор: s_client подключается к серверу по TLS, -servername задаёт имя для SNI (важно, когда на одном IP несколько сайтов), а x509 -noout -dates выводит только сроки действия сертификата.
Вывод вида:
notBefore=Jan 10 00:00:00 2026 GMT
notAfter=Jan 10 23:59:59 2027 GMT
notAfter — дата, после которой сертификат считается недействительным. Если до неё меньше двух недель — пора перевыпускать.
Проверка DNS — dig
dig +short example.com A
Вывод — IP-адрес, на который резолвится домен. Если пусто — DNS-запись пропала. Сравните с ожидаемым адресом сервера: если dig отдаёт другой IP, чем тот, на котором реально лежит сайт, — запись изменили или не обновили. Для проверки конкретного сервера имён:
dig +short example.com A @8.8.8.8
Эти три команды не заменяют мониторинг — они дают мгновенный снимок в момент расследования. Регулярный опрос и алерты делает панель.
Как поставить процесс на поток
Мониторинг для агентства — это не разовая настройка, а процесс. Вот как выстроить его так, чтобы он не требовал постоянного ручного вмешательства.
Шаг 1 — реестр. Соберите список всех клиентских сайтов с контактами владельцев, хостингом и сроками сертификатов/доменов. Это один документ, который живёт в агентстве.
Шаг 2 — базовые проверки. Для каждого сайта включите проверку доступности и SSL. Это минимум, который закрывает две самые частые причины простоя.
Шаг 3 — превентивные алерты. Настройте предупреждения об истечении сертификатов и доменов заранее, чтобы чинить до падения.
Шаг 4 — эскалация. Определите, кто в агентстве получает алерты и что делает. Для критичных клиентов — отдельный адрес или дежурный инженер.
Шаг 5 — отчётность. Заведите ежемесячный отчёт клиенту с аптаймом и инцидентами. Ритм важнее объёма.
Шаг 6 — приём нового клиента. Включите «подключить к мониторингу» в чеклист онбординга нового проекта, чтобы ни один сайт не остался без присмотра.
Мониторинг сайтов клиентов — это способ, которым агентство показывает профессионализм не словами, а реакцией: вы узнаёте о проблеме первым, чините до того, как клиент заметит, и раз в месяц подтверждаете работу цифрами. Настроить базовые проверки доступности и SSL для своего портфеля можно через проверку доступности сайта — это отправная точка, с которой процесс начинает работать сам.


